前言
去年我用 nsfwjs 搭过一个图片鉴黄服务,算是第一次真切感受到”前端也能跑机器学习”。今年大模型的热度肉眼可见地起来了,各种 AI 能力正在快速渗入前端的工作范围:智能抠图、语音识别、推荐排序……焦虑被取代没什么用,先把它塞进自己工具箱更实际。这篇文章就从一个最适合入门的项目讲起:在浏览器里实现一个手写数字识别画板——用户在 Canvas 上写个数字,模型实时告诉你这是几。整个项目不依赖任何后端,纯浏览器运行,代码可以直接跑起来。
1. 为什么机器学习开始进入前端视野
先聊聊为什么前端需要关心机器学习。三个理由:
- 端侧推理零成本落地。模型跑在用户浏览器里,不需要服务器 GPU、不需要按调用次数付费、数据不出设备,天然规避隐私合规问题。人脸检测、OCR、图片分类这类轻量任务,端侧方案的体验和成本都优于云端。
- 交互体验天然属于前端。模型推理结果如何呈现、如何引导用户修正、如何做动效反馈,这些本来就是前端的主场。AI 产品做得好不好,一半取决于交互。
- 2022 年这个节点,WebGPU 已经在 Chrome 里落地预览版,端侧推理性能瓶颈正在被打开,AIGC 的爆发大概率会把”模型即依赖”变成前端的常态。
而 TensorFlow.js(下面简称 TF.js)就是当下前端跑模型最成熟的库:可以直接加载 Keras/TF 训练好的模型,也支持在浏览器里现场训练,API 对 JS 开发者相当友好。
2. TensorFlow.js 架构与 WebGL 加速
TF.js 的分层架构可以用三句话概括:
- 最上层是 Layers API:仿照 Keras 的风格,
model.add(tf.layers.dense(...))搭网络、model.fit()训练、model.predict()推理,写起来和 Python 版几乎一样; - 中间是 Core API(ops):张量运算函数库,
tf.matMul、tf.conv2d这些算子,是 Layers 的底层支撑; - 最底下是后端(Backend):真正的计算引擎,这是性能的关键。
默认后端是 WebGL,原理是:把张量数据塞进 GPU 纹理(texture),卷积、矩阵乘法这些运算被编译成 GLSL 片段着色器(fragment shader),GPU 上千个流处理器并行计算,算完再把结果纹理读回来。可以这样类比:CPU 后端是一个人拿计算器逐个算,WebGL 后端是整个班级每人一台计算器同时算——哪怕每个核心比 CPU 慢,架不住数量碾压。
还有一个纯 JS 实现的 CPU 后端作为兜底(WebGL 不可用时自动降级),以及还在预览阶段的 WebGPU 后端,等它稳定后性能还会有量级提升。工程上要注意的是:GPU 纹理尺寸有限制,超大模型要切片加载;WebGL 上下文数量有限,页面里不要频繁创建销毁。
3. MNIST 与 CNN 通俗讲解
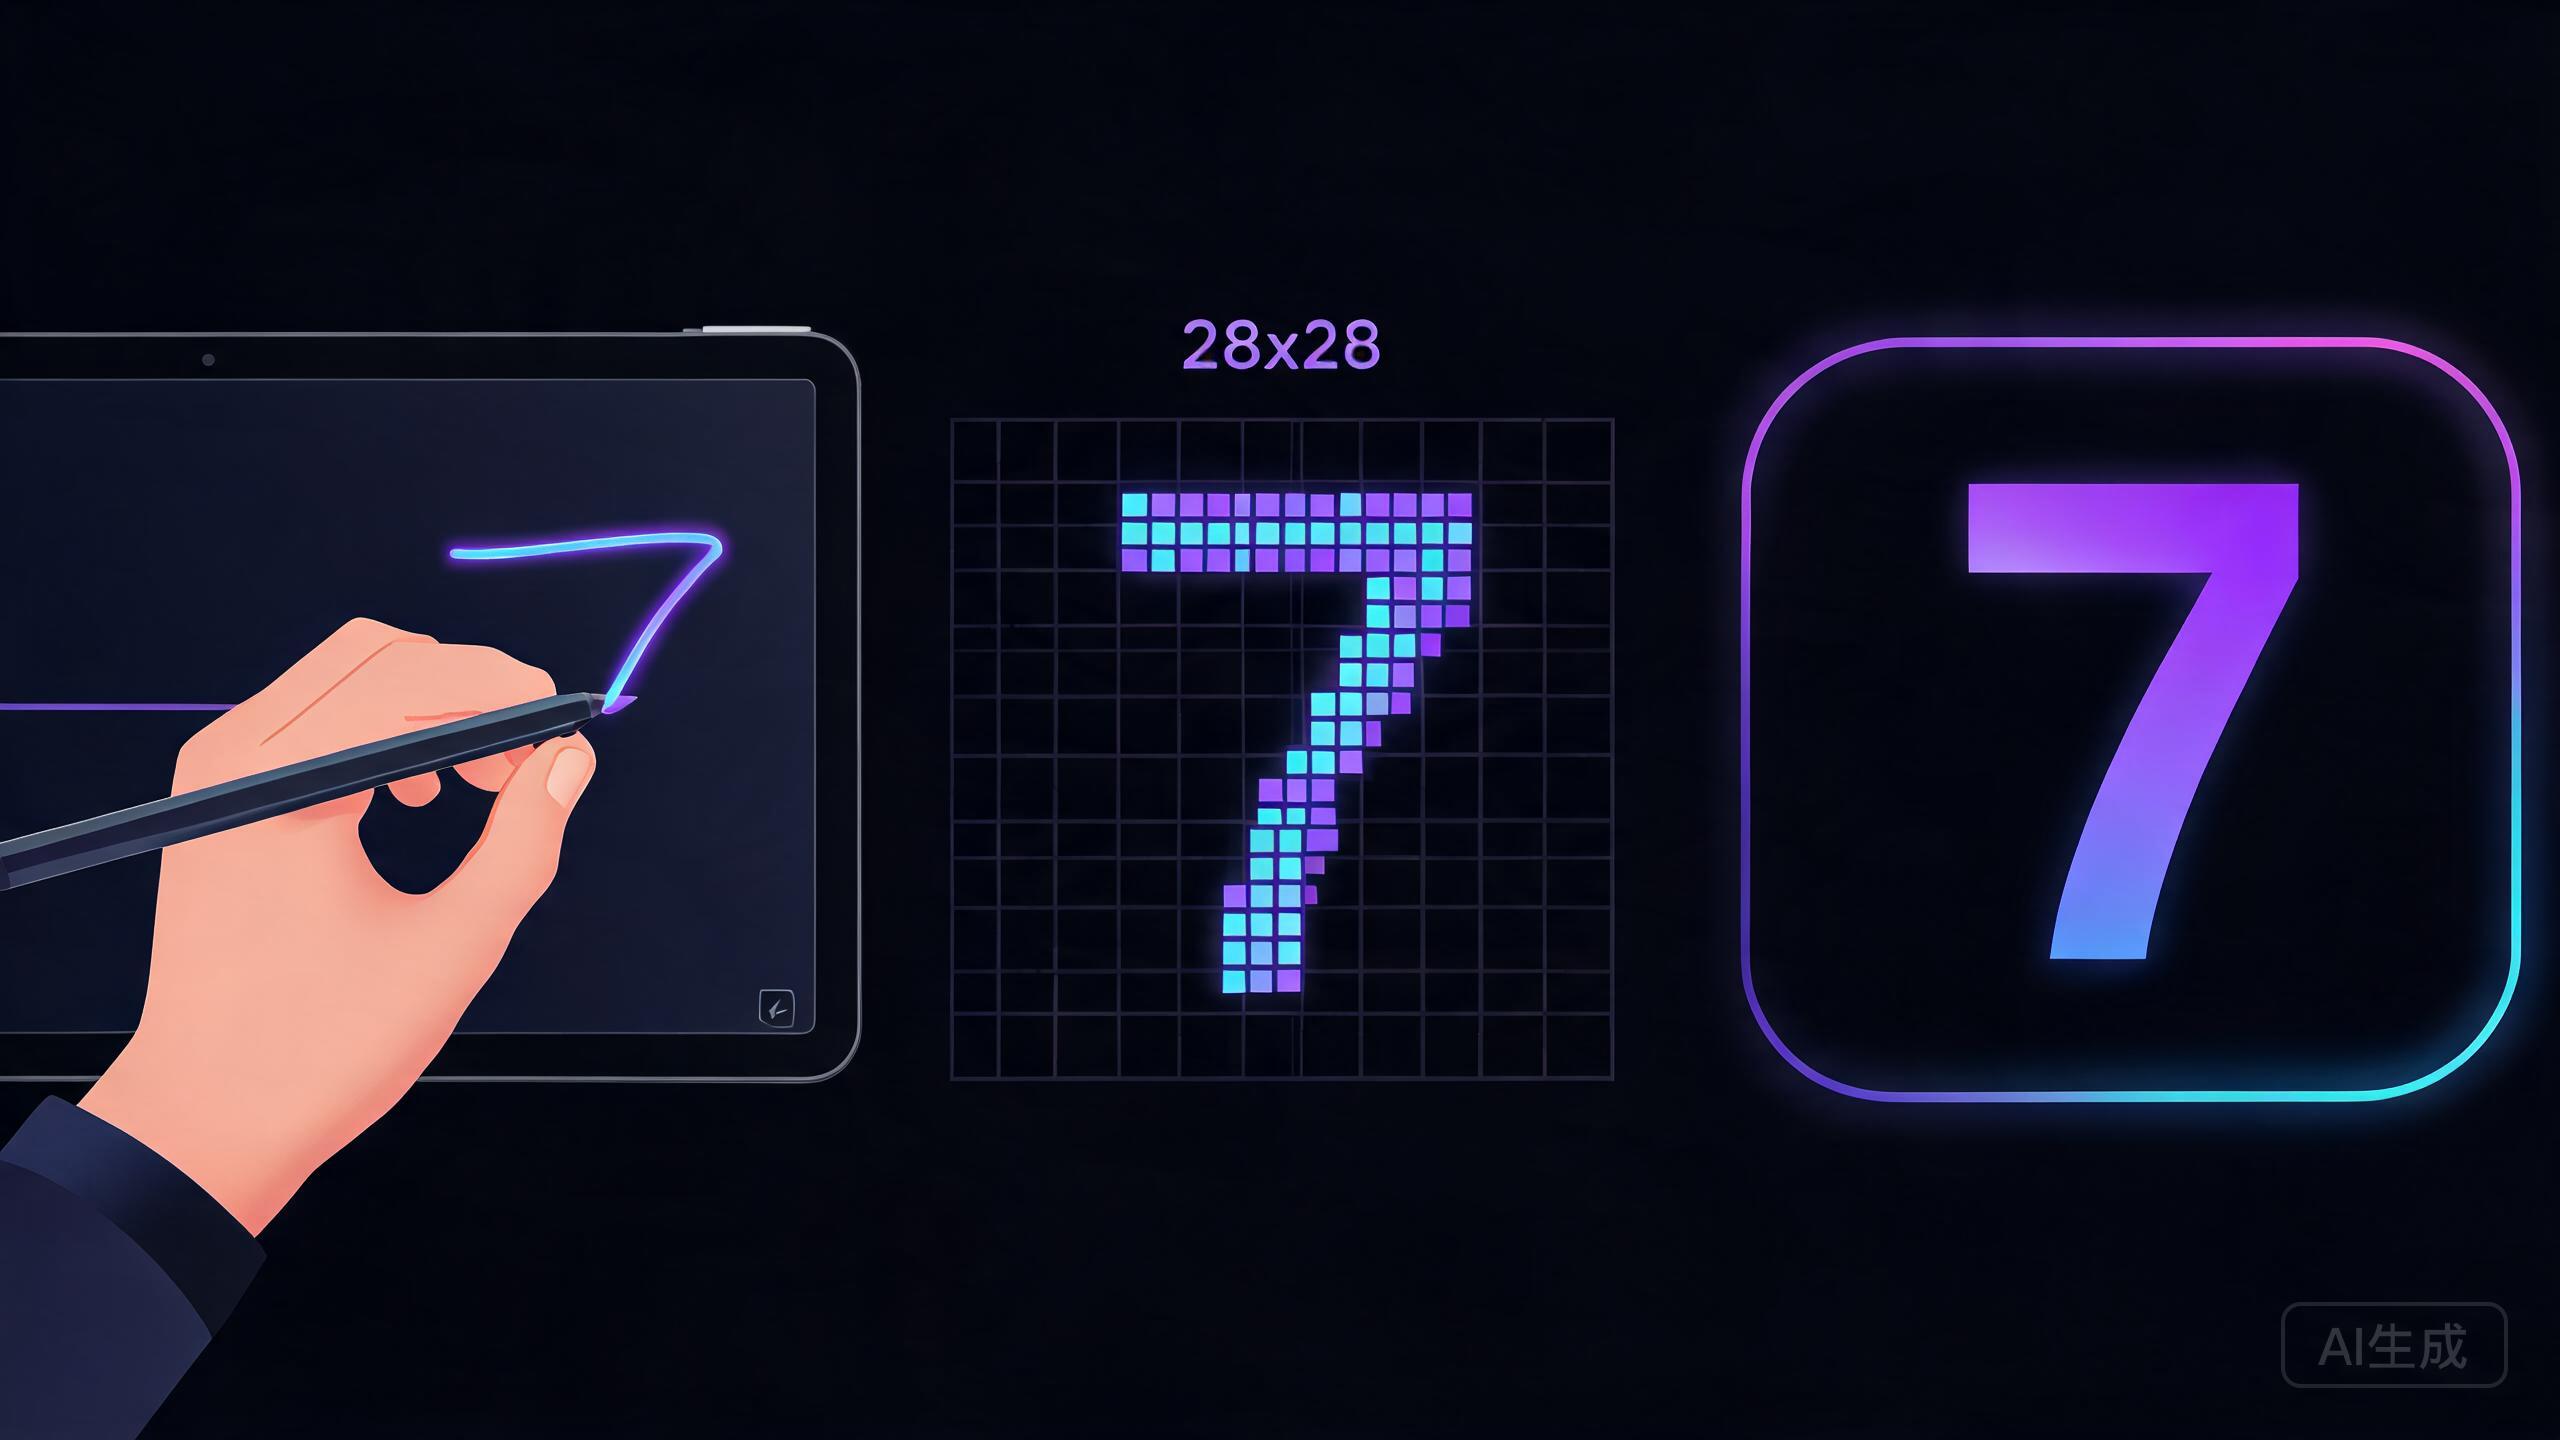
3.1 MNIST 数据集
MNIST 是机器学习界的”Hello World”:7 万张 28×28 像素的灰度手写数字图片(0-9),其中 6 万张训练、1 万张测试。我们的策略是不自己训练,直接加载社区在 MNIST 上训练好的预训练模型——前端工程师入门 ML,我强烈建议从”用模型”开始,训练的事交给数据和算力更充裕的人。
3.2 卷积:拿着放大镜找特征
CNN(卷积神经网络)为什么擅长看图?可以用”放大镜”来理解卷积:
想象你拿着一个 3×3 的小放大镜,从图片左上角开始,一格一格地滑动扫描整张图。每停留一处,就做一次小计算:放大镜视野内的 9 个像素值,分别乘上放大镜里预设的 9 个权重(这组权重叫卷积核/kernel),加起来得到一个数。这个数表示”该位置与这个特征的匹配程度”。
一个卷积核只找一种特征(比如”左上到右下的斜线”),而 CNN 第一层会有几十上百个不同的卷积核同时扫图,每个核输出一张”匹配热度图”(特征图,feature map)。所以第一层卷积学到的往往是横线、竖线、弧线这类基础笔画;第二层卷积在第一层结果上继续扫,把基础笔画组合成”圆圈””交叉”这类部件;第三层再组合成”这是 8 的上半圆 + 下半圆”这样的高级特征。层层堆叠、由简到繁,这就是 CNN 的精髓。
3.3 池化:抓住重点
卷积之后紧跟一步池化(pooling),最常见的是最大池化(MaxPooling):把特征图切成 2×2 的小块,每块只保留最大的那个数。相当于把特征图从 28×28 压到 14×14,信息密度更高,后续计算量降到四分之一,同时让识别对数字的轻微位移不敏感——数字写歪一点也能认出来。
一个典型的 MNIST CNN 结构(也是我们加载的模型的形状):
1 | 输入 28×28×1 灰度图 |
4. 完整实现:Canvas 画板 + 预训练模型识别
4.1 页面结构
先搭一个最小可用的页面:一个画板、一个清除按钮、一个识别结果显示区。
1 | <div class="board-wrap"> |
画板设为 280×280(10 倍于模型输入 28×28),纯粹是为了手写体验,后面会缩放处理。
4.2 画板:支持鼠标和触屏的统一封装
1 | const board = document.getElementById('board'); |
4.3 加载预训练模型
模型我用的是社区常见的 MNIST CNN 模型(可以从 tfjs-examples 仓库获取,或自行用 Python 训练后用 tfjs-converter 转换)。加载后立刻预热一次推理,消除首次识别的明显延迟(首次推理包含 shader 编译):
1 | let model; |
4.4 关键代码:Canvas 像素 → 28×28 张量
这是整个项目的核心:模型吃的是 [1, 28, 28, 1] 形状的四维张量(batch × height × width × channel),而画板是 280×280 的 DOM 元素。转换分五步:提取像素 → 转灰度 → 缩放到 28×28 → 归一化到 0~1 → 加 batch 维度:
1 | function predict() { |
写完在浏览器里画一个 7,控制台输出 识别结果:7(置信度 96.4%),一个完全跑在浏览器里的手写识别应用就成了。
5. 踩坑记录
下面三个坑,每个都让我调试了不止半小时,记录下来给后来者。
5.1 normalize 不做或做错,识别率直接崩
深度模型对输入分布极其敏感。训练时 MNIST 像素被除以 255 归一化到 01,如果推理时你直接喂 0255 的原始像素,对模型来说输入”大了 255 倍”,激活值全部饱和,识别结果基本等于随机猜。反过来,如果你用的模型训练时做了 -1~1 标准化((pixel/255 - 0.5) / 0.5),你却按 0~1 处理,一样崩。预处理必须和训练时严格一致——拿到任何模型,第一件事就是确认它的训练预处理管线,这一条适用于所有推理任务。
5.2 canvas 底色:黑底白字 vs 白底黑字
这是最容易漏掉的一个坑。MNIST 训练图是黑底白字(笔画像素值接近 255,背景接近 0)。你的 Canvas 如果是默认透明底或白底黑字,缩放归一化后笔画是”深色的洞”,和训练分布完全相反,模型会自信地输出错误答案(而且置信度还很高,非常迷惑人)。
解法就是 4.2 里的做法:初始化时用黑色填充整个画布,笔迹用白色。如果你的产品 UI 需要白底黑笔(比如手写输入法场景),可以在推理前对张量做一次取反:tf.sub(1, normalized)。
5.3 内存释放:tf.tidy 与手动 dispose
TF.js 的张量在 WebGL 后端是真实的 GPU 纹理,不释放就是显存泄漏,画几次之后页面会越来越卡直到浏览器崩溃。它不像 JS 对象那样有完备的 GC(GPU 侧资源需要显式管理),两个习惯要养成:
- 用
tf.tidy(() => {...})包住所有中间张量创建逻辑,函数返回值以外的张量自动释放,这是官方推荐的”自动内存管理”; predict的输出张量不在 tidy 作用域管理范围内,用完必须手动output.dispose(),或者用tf.tidy把 predict 也包进去返回结果。
调试时可以用 tf.memory() 打印当前张量数量和显存占用,画板场景每写一个数字,numTensors 应该回落到同一水平线;持续上涨就是在泄漏。
写在最后
这个项目从零到能跑,实际代码不到 150 行,但它完整串起了”前端跑 ML”的所有关键环节:模型加载、输入预处理、推理调度、内存管理。理解了这四个词,再看 nsfwjs、人脸检测、语音识别这些项目,你会发现模式完全一样,无非是模型更大、预处理更复杂。
下一篇我打算把 WebGPU 后端和 WebGL 拉出来跑同一组模型做实测,看看这个预览版后端到底能快多少。在那之前,你要是想把这套流程换成自己的模型,先去确认训练时的预处理——5.1 那个坑,我在公司另一个模型上又踩了一次。