浏览器端 AI Agent 初探:让模型替你操作网页
前言上个月有个同事让我帮忙核对后台系统里三百多个商品的库存信息,逐个点进去、复制、填到表格里。我第一反应是写个 Playwright 脚本,第二反应是:等一下,2026 年了,为什么还要手写死脚本?让大模型看着页面自己操作不行吗?
于是有了这次实验。这也是系列里第一次把 AI 从”聊天框”里请出来、放到浏览器上动手。从 2023 年的 ChatGPT API、2024 年的 RAG 和 Function Calling、2025 年的 MCP,AI 一直活在对话界面里。而 Browser Agent 是把 AI 放回它最原始的战场:浏览器本来就是人类操作的 GUI,让模型学会点按钮、填表单,等于把整个 Web 世界变成了 AI 的执行环境。
这篇文章我会先讲清楚 Browser Agent 的核心思路,然后用 Playwright + 大模型手搓一个最小可用的网页操作 Agent,最后聊聊可靠性、安全边界,以及对测试自动化和 RPA 的影响。
1. Browser Agent 崛起:浏览器就是 GUI1.1 核心思路:感知-决策-执行循环Web Agent 的本质是一个闭环:把页面”翻 ...
上下文工程:比 Prompt 工程更进一步
前言2023 年我写《ChatGPT API 之初体验》那会儿,圈内讨论的还全是 Prompt 工程:怎么写一句”你是一位资深专家”、怎么加一句”让我们一步一步思考”、怎么用 few-shot 举例子。那时候模型窗口只有 4K、8K token,一次能塞进去的信息极其有限,”把一句话说到点子上”就是全部功夫。
三年过去,情况彻底变了。2026 年的模型,200K 上下文是标配,长上下文模型普遍到了百万级 token。窗口不再稀缺,新的问题反而冒出来了:上下文里塞的东西越多,模型表现并不见得更好,甚至越来越笨。
于是行业里出现了一个新词:Context Engineering(上下文工程)。它回答的问题不再是”这句话怎么写”,而是”在每次模型调用之前,往上下文里放什么、不放什么、以什么结构放”。最近半年我在一个多轮客服 Agent 项目里被这个问题反复毒打,这篇文章就把踩过的坑和沉淀的做法一次性聊清楚。
1. 从 Prompt 工程到 Context 工程1.1 窗口变大之后,问题变了Prompt 工程时代的假设是:上下文很小,所以每一句话都要精雕细琢。而上下文工程的假设是:上下文很大, ...
AI 编程工具大盘点:Cursor、v0 与我的工作流重构
前言从 2023 年写 ChatGPT API 接入开始,到今年研究 MCP、做多模态,AI 已经从”我研究的对象”变成了”我干活的工具”。这一年我把主流 AI 编程工具都重度用了一遍:Cursor 当主力 IDE、v0 出原型、Claude Code 跑终端任务,工作流几乎被重塑了一遍。
年底正好适合做个盘点。这篇文章先横向梳理 2025 年 AI 编程工具的格局,然后完整还原我现在的开发工作流——从需求到上线,每一步用什么工具、喂什么 Prompt,最后聊聊哪些活儿交不掉,以及我对前端岗位的一点思考。
1. 2025 年 AI 编程工具格局
1.1 四类玩家,四种定位一年用下来,我把工具归成四类,关键是认清各自的生态位:
IDE 深度集成型(Cursor、Windsurf):编辑器即 Agent。优势是上下文全——能索引整个代码库,改代码、跑命令、看 diff 一气呵成。适合在既有仓库里做中大型改动,是我现在 80% 时间的主战场;
终端 Agent 型(Claude Code、Codex CLI):活在终端里,擅长跨文件的多步任务:批量重构、补测试、修 CI、生成文档。不需要 ...
从 SSR 到流式 AI UI:Edge 渲染新范式
前言我入行那会儿正好赶上 CSR(客户端渲染)的黄金年代,后来又亲历了 SSR 的回归、SSG 的流行,再到 React Server Components 的落地。每一次范式切换,本质上都是在回答同一个问题:”HTML 到底在什么时候、什么位置生成?”
今年做 AI 相关项目时我意识到,LLM 的 token 流正在成为第四种”渲染源”——页面不再只是从服务器或客户端拿现成的数据来渲染,而是随着模型的输出逐步”长”出来。这篇文章梳理这条渲染范式的演进线,再讲讲我在 Edge 上做 LLM 代理的实践:用 Vercel AI SDK 的 useChat 对比手写 SSE 到底简化了多少。
1. 渲染范式演进:一条线看懂1.1 从 CSR 到 RSC,再到 AI 流式 UI先用文字把这条线串起来:
123456CSR → 浏览器下载空壳 JS → 拉数据 → 客户端渲染(白屏久,SEO 差)SSR → 服务器在请求时渲染完整 HTML → 客户端 hydration(首屏快,服务器压力大)SSG → 构建时生成静态 HTML(最快,但内容不实时) ...
多模态实践:用 Vision API + Web Audio 打造看图说话应用
前言去年那篇 DeepSeek 接入的文章里,我玩的还是纯文本对话。这半年多模态能力肉眼可见地成熟了:GPT-4o、Claude、Gemini 的视觉能力已经能用于生产,语音对话也成了各家产品的标配。作为一个前端工程师,我更关心的问题是:浏览器端的 Web API 能把大模型的多模态能力用到什么程度?
于是我做了一个小玩具:”看图说话”应用:用户上传(或拍)一张图,模型看图输出结构化结果,用户可以直接语音提问,应用把回复朗读出来。这篇文章把整个过程拆开讲:图片压缩、结构化识图、Web Audio 录音与波形可视化、语音转文字、TTS 朗读,外加一筐 iOS Safari 的坑。
1. 多模态大模型能力概览现在的多模态模型大致有四类能力,对前端来说都能通过 API 用起来:
图片理解(Vision):识图、OCR、图表解读、UI 走查,这是本文的重点;
音频输入(ASR):语音转文字,或者直接音频进音频出(Realtime 这类);
语音输出(TTS):把文本转成自然语音,比 Web Speech API 的合成音自然得多;
视频与文档理解:抽帧送 Vision,或者直接传 PDF。
...
前端接入 DeepSeek 大语言模型技术实现
前言随着人工智能技术的快速发展,大语言模型(LLM)已经成为前端开发中不可或缺的一部分。DeepSeek作为国内领先的大语言模型,提供了强大的对话能力和API接口,使得前端开发者可以轻松地将AI对话功能集成到自己的应用中。
本文将从前端开发者的角度,详细介绍如何接入DeepSeek大语言模型,实现一个完整的对话系统,包括API调用、流式响应处理、错误处理、用户体验优化等关键技术点。
1. DeepSeek API 概述DeepSeek提供了RESTful API接口,支持多种编程语言调用。对于前端开发者来说,最常用的是对话补全(Chat Completion)接口。
1.1 API 基础信息
基础URL: https://api.deepseek.com
认证方式: Bearer Token
主要端点: /v1/chat/completions
支持模型: deepseek-chat, deepseek-coder等
1.2 请求格式123456789101112131415const requestBody = { model: "deepseek-ch ...
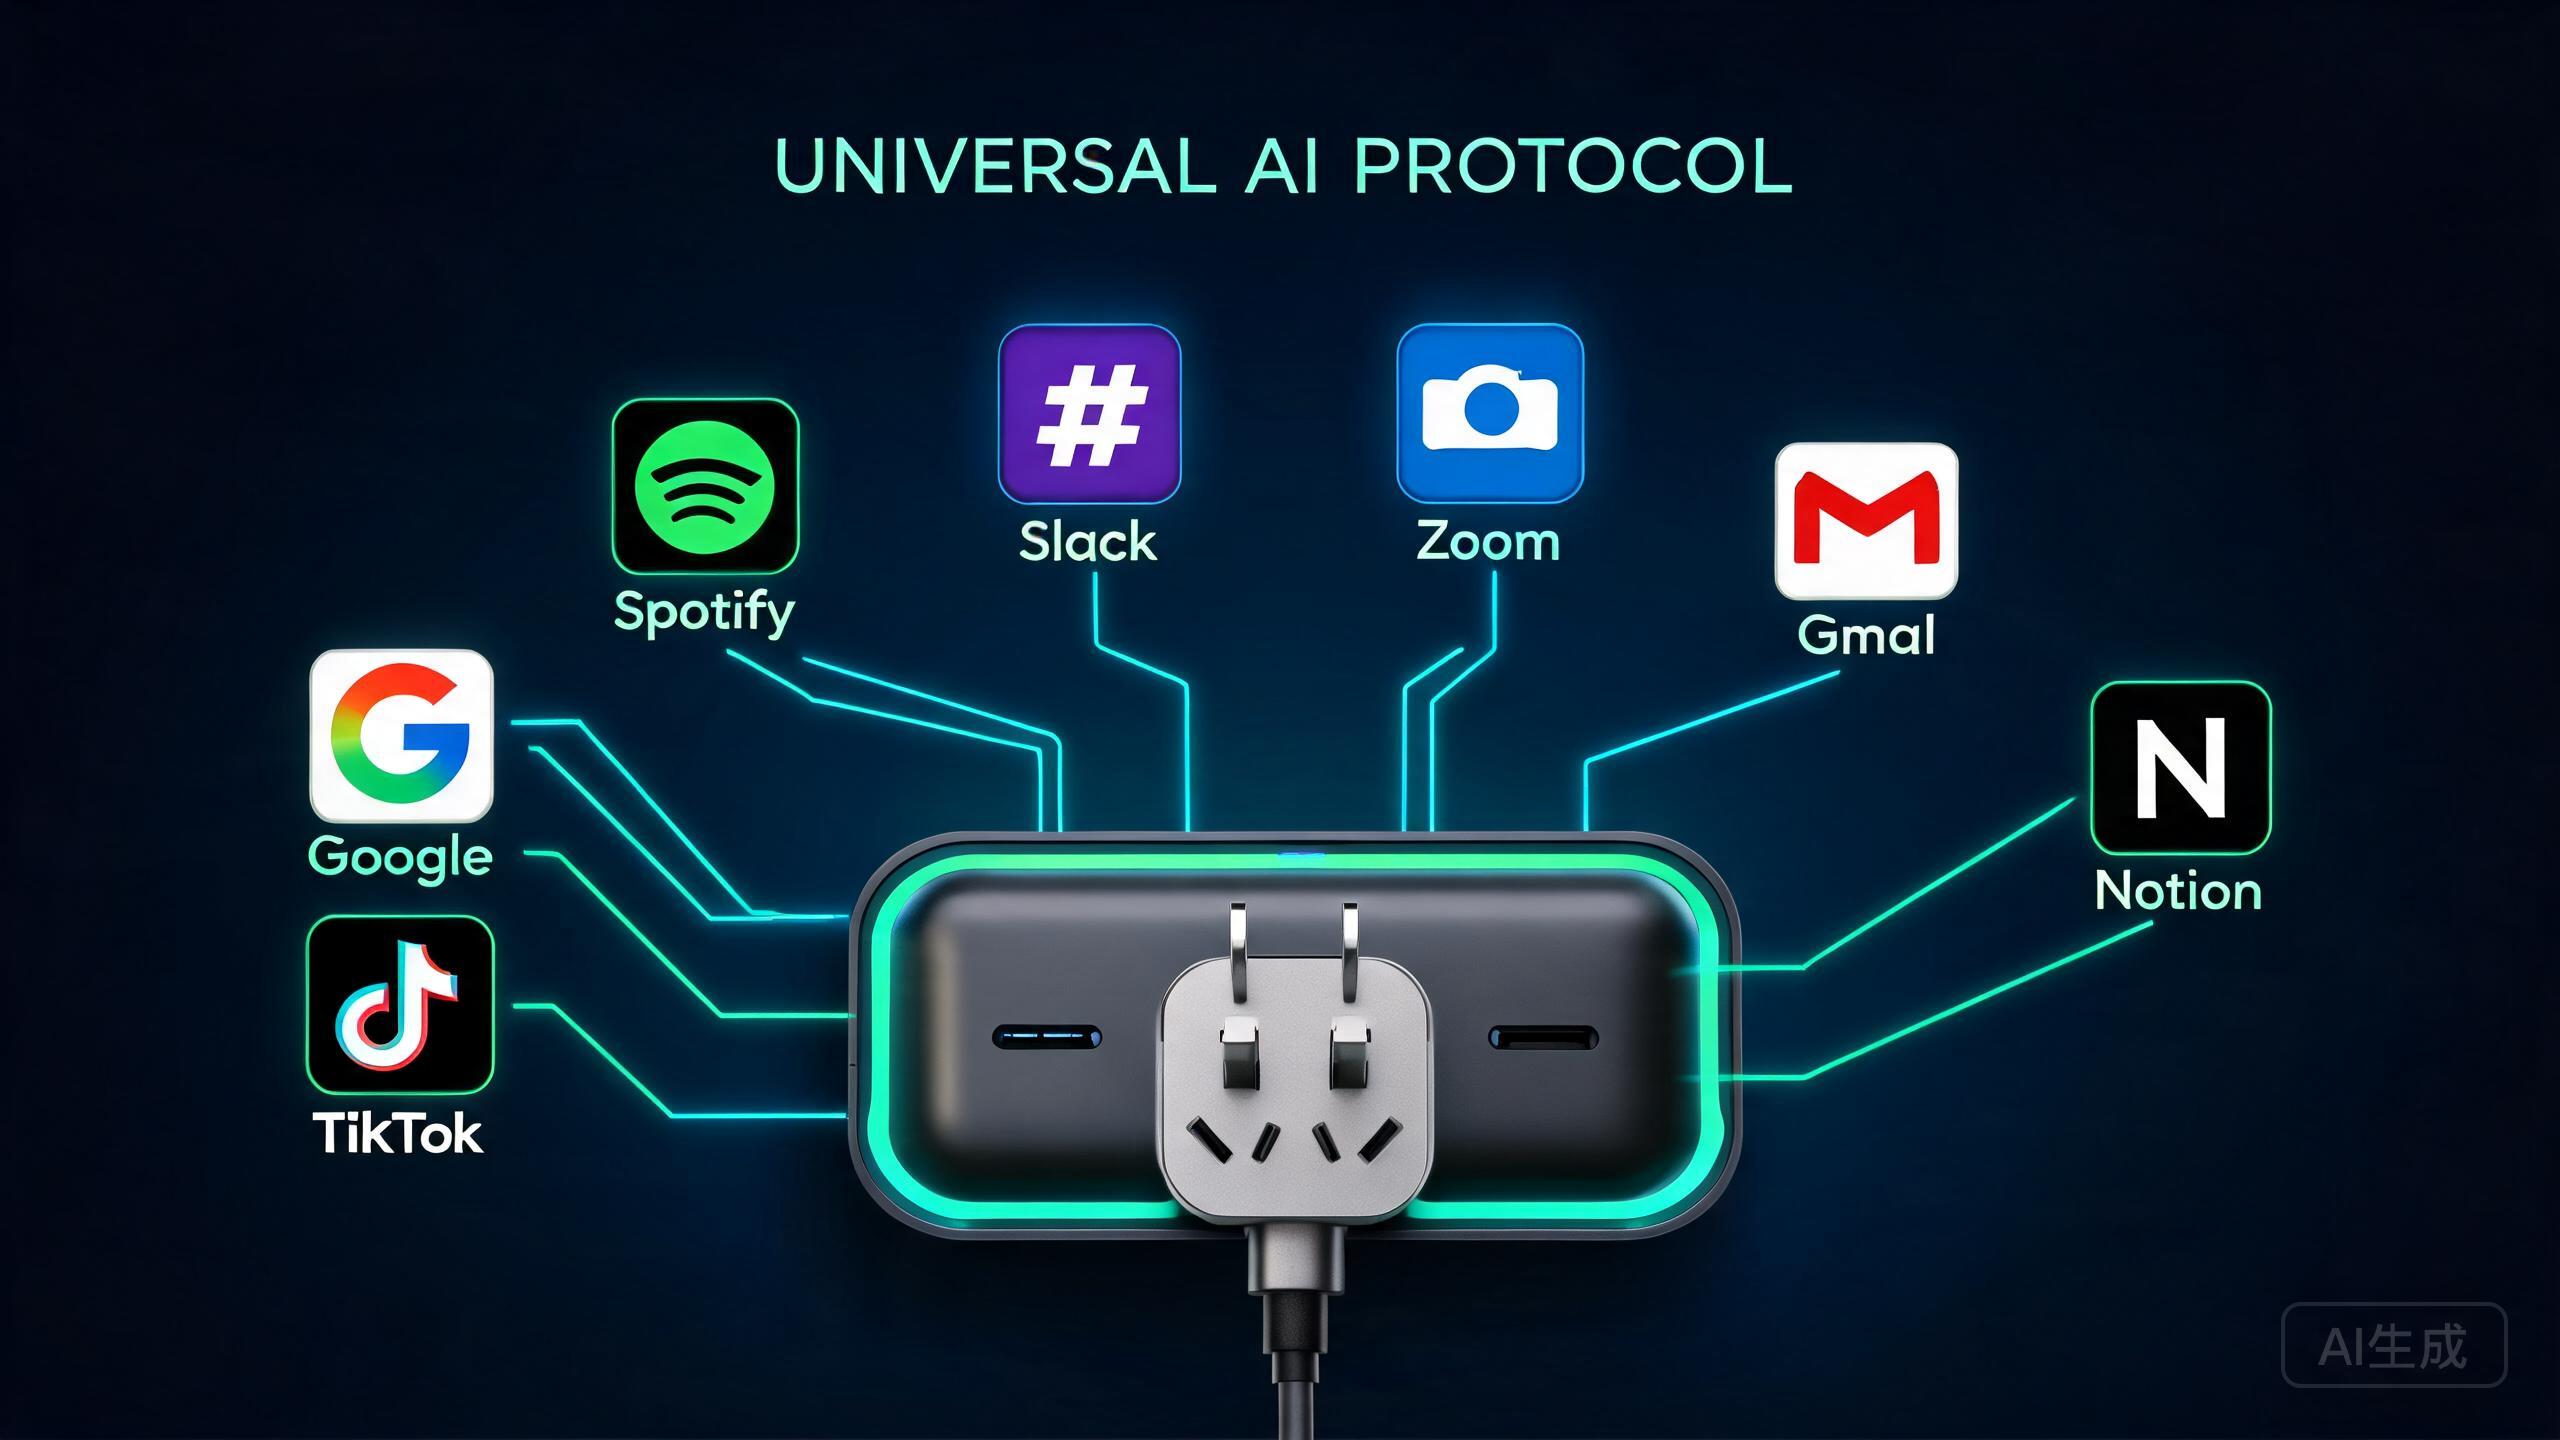
MCP 浅尝:Model Context Protocol 前端接入指南
前言去年写 Function Calling 和 Agent UI 那几篇文章的时候,我反复遇到同一个困扰:让大模型”接上”真实世界的数据,每个应用、每个数据源都得单独写一遍胶水代码。给 Claude 接 GitHub 是一套封装,给 Cursor 接同样的 GitHub 又是另一套,自己写的客服机器人想查数据库还得再来一遍。这些适配逻辑高度雷同,却完全无法复用。
今年年初我认真研究了 Anthropic 开源的 Model Context Protocol(下文简称 MCP),越看越觉得它像是 AI 应用生态里的”USB-C 接口”。这篇文章从前端视角聊聊:MCP 到底解决什么问题、架构长什么样,以及如何动手写一个最小可用的 MCP Server,最后附上我踩过的坑。
1. MCP 是什么:从 M×N 到 M+N1.1 M×N 集成难题在 MCP 出现之前,AI 应用接入外部能力是一个典型的 M×N 问题:M 个 AI 应用(Claude Desktop、Cursor、各种自研 Agent)要对接 N 个数据源(GitHub、Slack、Postgres、本地文件……),理论上最多要 ...
AI Agent 时代的 UI 设计:流式界面、乐观更新与 Generative UI
前言今年从 Function Calling 写到 Agent,我越来越意识到一件事:大模型挑战的不只是后端架构,而是我们做前端的底层假设。传统前端的交互是”确定性的”——用户点按钮,请求接口,返回数据,渲染结果,每一步都可预测。而 Agent 是一个黑盒:它可能思考三秒,也可能跑三分钟;可能一步答对,也可能调五次工具绕弯路;用户甚至不知道它此刻在干什么。老的一套 loading + 表格 + 弹窗的交互范式,接不住这种不确定性。这篇是今年 AI 系列的收官,聊聊这一年我思考最多的三个 UI 命题:流式界面、乐观更新、Generative UI。
1. 传统 CRUD UI vs AI 原生 UI先把两种范式摆在一起对比,差异一目了然:
维度
传统 CRUD UI
AI 原生 UI
响应时间
毫秒~秒级,确定
不确定,可能数十秒
结果
固定结构的数据
自由文本 + 结构混合
过程
黑盒 loading
可展示的推理与工具调用过程
用户操作
精确指令(点、填、选)
模糊意图(一句话)
错误处理
明确的成功/失败
部分正确、需要追问澄清
核心反馈
loadi ...
Function Calling 实战:让大模型学会调用前端工具
前言前面几篇我们把大模型接进了前端:聊天、流式输出、RAG 知识库,一路走来模型越来越”博学”。但用着用着你会发现,它始终停留在”动嘴”层面——用户说”帮我把页面切成深色模式”,模型只能回复”您可以点击右上角的设置按钮……”。它不能做事,因为它没有手。这篇要讲的 Function Calling(函数调用)就是给模型装上手的过程:模型负责理解意图、决定调什么工具、给出参数,而执行权始终在我们前端代码手里。这是从聊天机器人迈向 AI 应用、乃至 Agent 的关键一步。
1. 从”会说话”到”会做事”回顾一下我们已有的能力边界:
普通对话:模型只能生成文本,建议用户”自己去做某事”;
RAG:模型能基于检索资料回答,但依然只输出文本;
Function Calling:模型可以输出一个结构化的”我要调用某工具 + 参数”,由我们的代码执行后把结果喂回去,它再基于真实结果继续对话。
一个直观的对比:用户问”北京今天适合跑步吗”——普通模式下模型会说”建议查看天气预报”(或者干脆编一个天气);Function Calling 模式下,模型会返回”请调用 getWeather 工具,参数 ...
WebGPU 时代:在浏览器里本地跑大模型
前言上次写 RAG 的时候,我们的知识库问答还架在 Node 服务上,模型跑在云端,每次提问都要走一轮网络请求。当时我就在想一个问题:能不能让用户浏览器自己把模型跑了?不调 API、不上传数据、零推理成本——听起来像天方夜谭,但 2024 年这事儿真的成了。WebGPU 的普及让浏览器第一次拥有了通用 GPU 计算能力,WebLLM 这样的项目已经可以在 Chrome 里流畅跑 Llama-3 和 Mistral。这篇就来聊聊 WebGPU 到底是什么,以及怎么在自己的页面里把大模型跑起来。
1. WebGPU 是什么:不只是”WebGL 继任者”1.1 与 WebGL 的区别很多文章把 WebGPU 介绍成”WebGL 的下一代”,这话只对了一半。图形渲染确实是 WebGPU 的一部分,但它真正的质变在于通用计算(GPGPU):
Compute Shader 一等公民。WebGL 的设计初衷是画三角形,想借用 GPU 算点别的东西,得把数据伪装成纹理、把计算伪装成片元着色器,各种拧巴。WebGPU 原生提供 compute pipeline,你可以直接在 GPU 上开辟存储缓冲区( ...