前言
上次写 RAG 的时候,我们的知识库问答还架在 Node 服务上,模型跑在云端,每次提问都要走一轮网络请求。当时我就在想一个问题:能不能让用户浏览器自己把模型跑了?不调 API、不上传数据、零推理成本——听起来像天方夜谭,但 2024 年这事儿真的成了。WebGPU 的普及让浏览器第一次拥有了通用 GPU 计算能力,WebLLM 这样的项目已经可以在 Chrome 里流畅跑 Llama-3 和 Mistral。这篇就来聊聊 WebGPU 到底是什么,以及怎么在自己的页面里把大模型跑起来。
1. WebGPU 是什么:不只是”WebGL 继任者”
1.1 与 WebGL 的区别
很多文章把 WebGPU 介绍成”WebGL 的下一代”,这话只对了一半。图形渲染确实是 WebGPU 的一部分,但它真正的质变在于通用计算(GPGPU):
- Compute Shader 一等公民。WebGL 的设计初衷是画三角形,想借用 GPU 算点别的东西,得把数据伪装成纹理、把计算伪装成片元着色器,各种拧巴。WebGPU 原生提供 compute pipeline,你可以直接在 GPU 上开辟存储缓冲区(storage buffer),让成千上万个线程并行地做矩阵乘法——而这正是神经网络推理的核心操作。
- 更接近现代图形 API。WebGPU 的设计对标 Vulkan / Metal / D3D12:显式管理管线、绑定组和资源,开销更低、控制力更强。写起来比 WebGL 繁琐一点,但性能上限高得多。
- 一套 API,跨平台一致。底层自动映射到各平台的现代图形后端,不用再像 WebGL 时代那样对着各家驱动的奇葩 bug 挠头。
一个最小的 compute shader(WGSL)长这样,感受一下它有多”正经”:
1 | const adapter = await navigator.gpu.requestAdapter(); |
navigator.gpu 能拿到 adapter,说明浏览器支持 WebGPU。目前 Chrome / Edge(桌面)已经稳定支持,Safari 和 Firefox 也在跟进中,可以用下面的代码做特性检测和优雅降级:
1 | if (!navigator.gpu) { |
1.2 为什么 WebGPU 是端侧 AI 的钥匙
大模型推理的计算本质就是超大规模的矩阵乘法,天然适合 GPU 并行。在 WebGPU 之前,浏览器里的 JS 想做矩阵运算只能靠 CPU(慢几个数量级)或者 WebGL 的各种”歪门邪道”(限制多、精度差)。WebGPU 一来,浏览器第一次拿到了”正经干活”的 GPU 通道,剩下的就是软件层的事了——WebLLM 和 Transformers.js 就是干这个的。
2. 端侧 AI 的双重诱惑:隐私与成本
在浏览器本地跑模型,不只是炫技,它解决了云端方案的两个老大难:
隐私。数据不出设备。对医疗、法律、金融这类敏感场景,”用户输入永远不会离开浏览器”本身就是产品卖点。哪怕做匿名化,服务端方案也总有合规成本,端侧方案直接物理隔绝了这条风险。
成本。云端 API 按 token 计费,用户量一大账单很感人;自建推理服务则要养 GPU 服务器。端侧方案的推理算力由用户设备免费提供——是的,用户替你付了电费。边际成本几乎为零,这对长尾、低频但对隐私敏感的功能(比如输入框里的智能改写)非常合适。
当然代价也有:模型要下载到用户设备(几百 MB 到几个 GB)、受限于用户硬件、没有云端旗舰模型聪明。所以我的实践结论是:端侧适合”轻量、高频、隐私敏感”的功能,云端适合”重量级”任务,两者混搭。
3. WebLLM 实践:浏览器里跑 Llama-3
3.1 创建 Engine 与模型加载
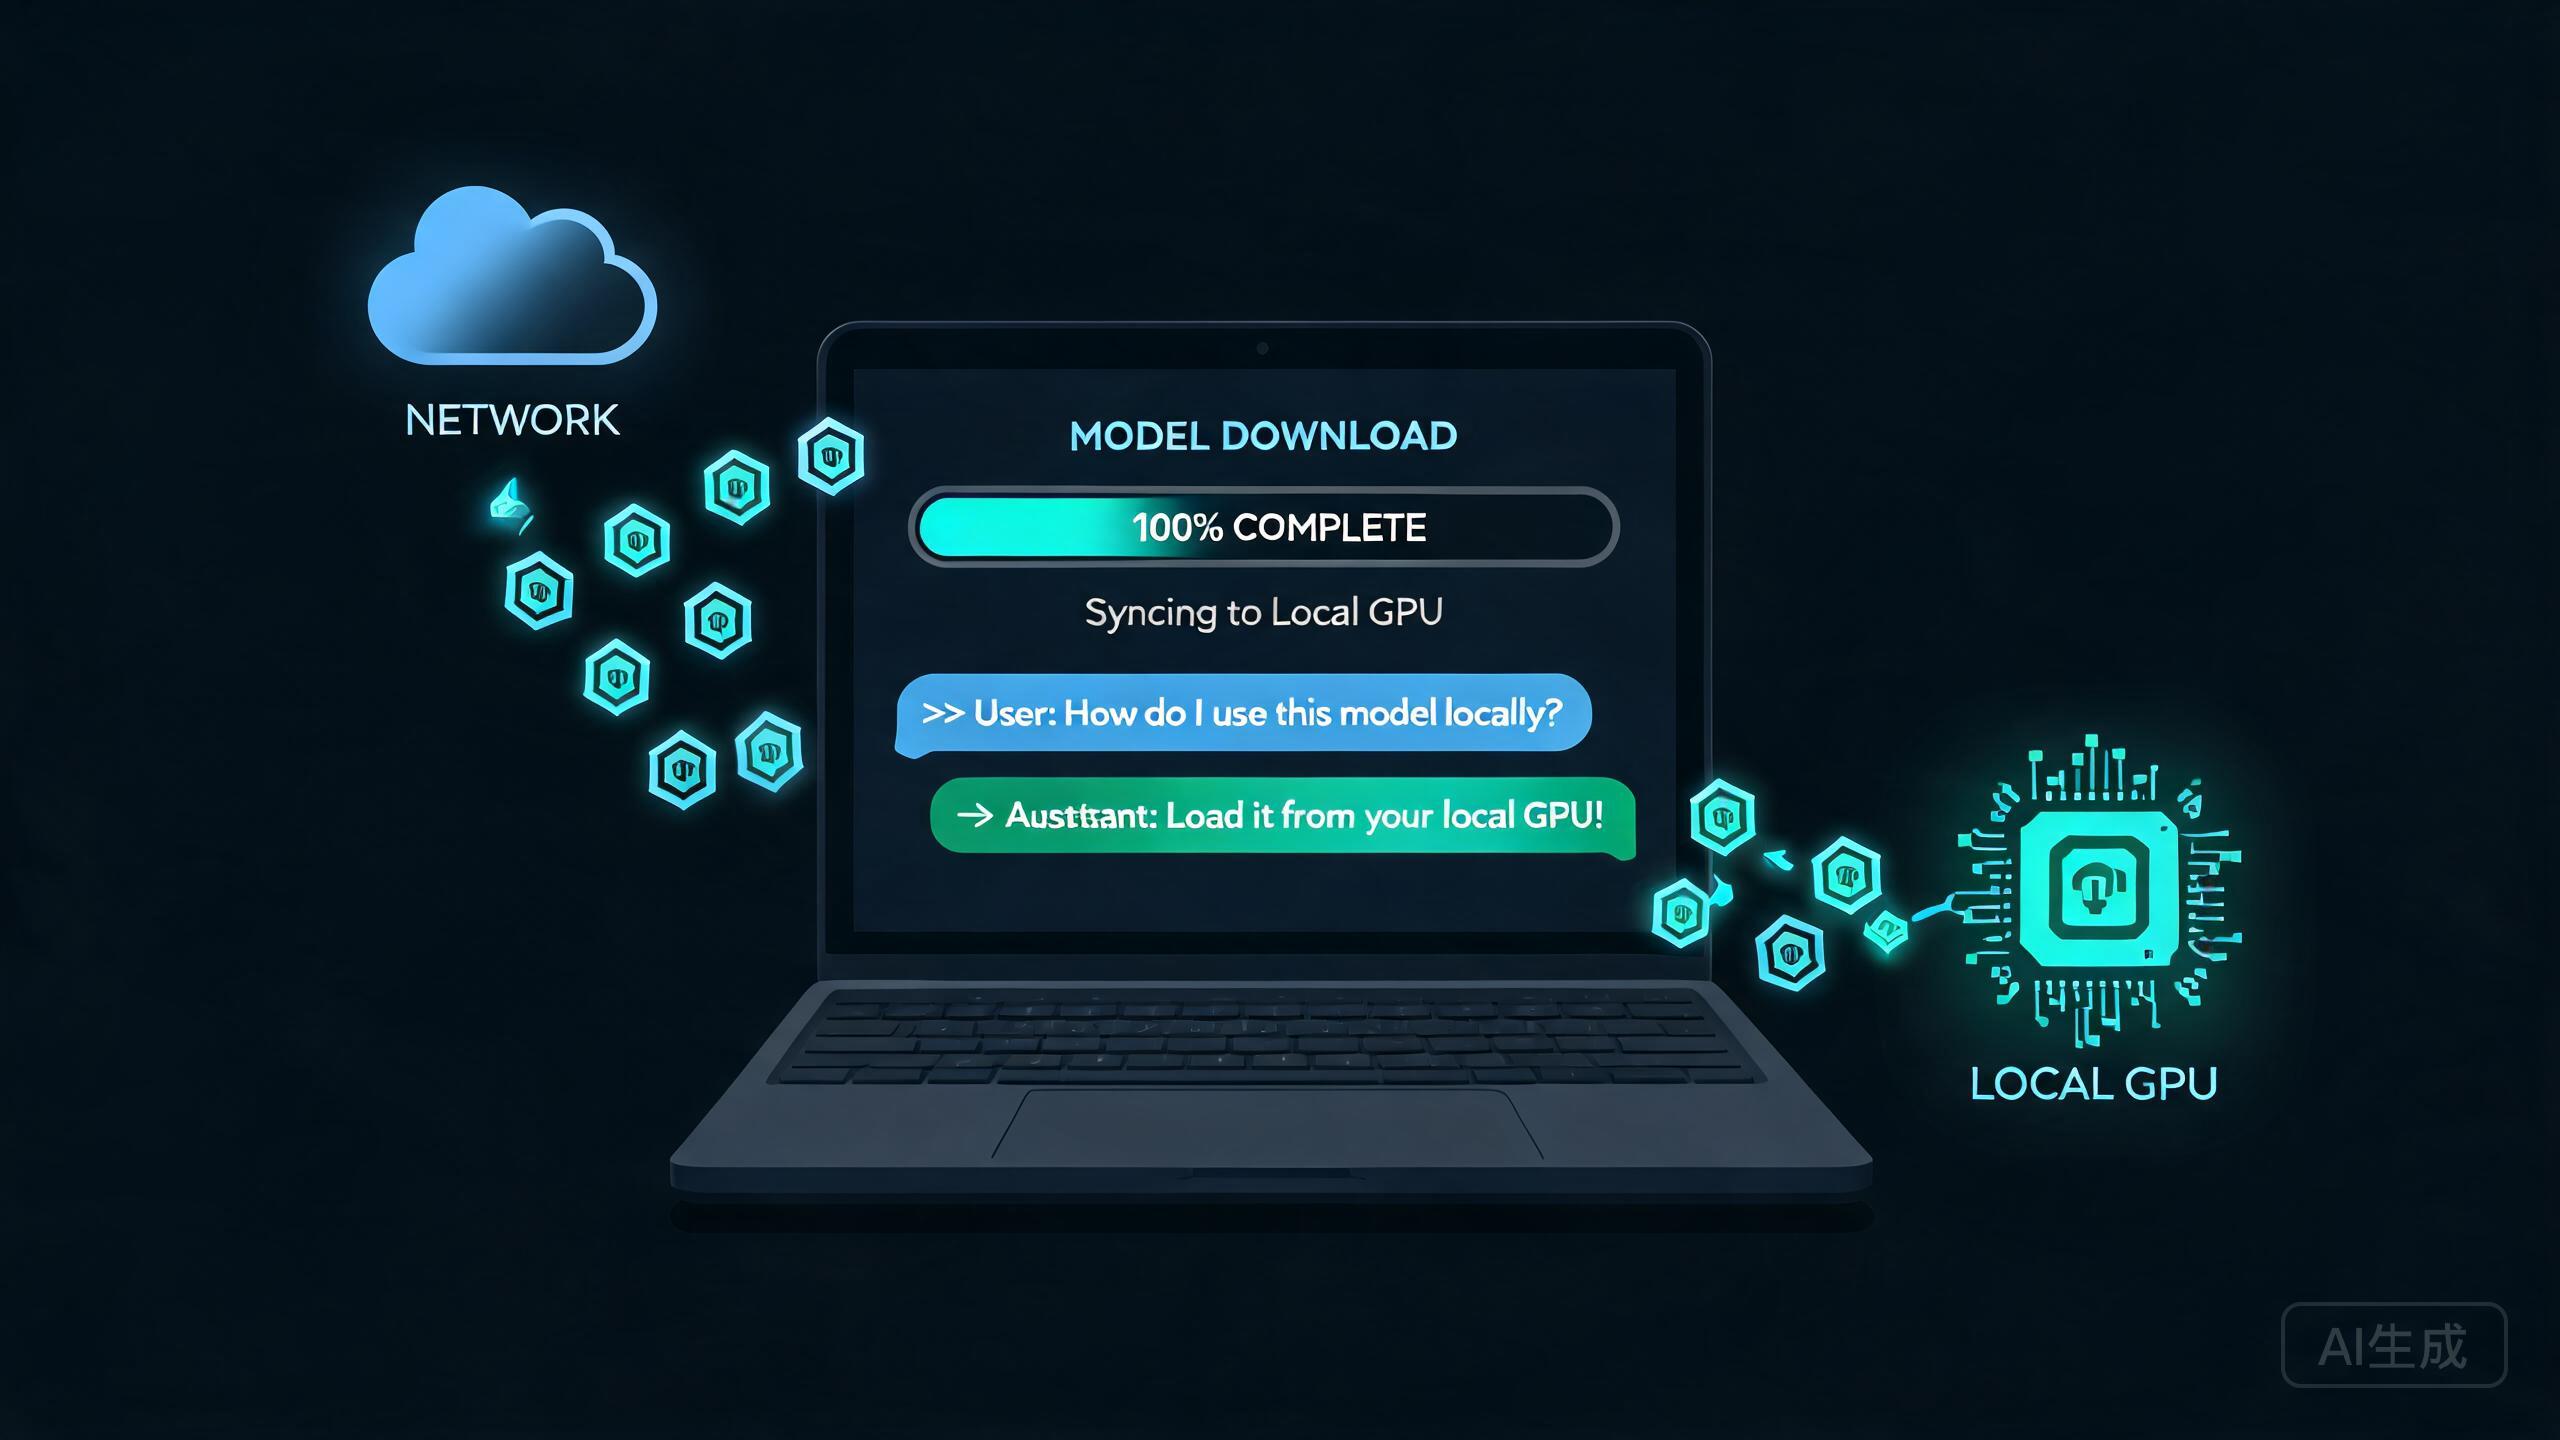
WebLLM(mlc-ai/web-llm)是 MLC 团队的项目,把 LLM 编译成 WebGPU 上可运行的版本,并且封装了一个类 OpenAI 的接口,上手非常顺滑:
1 | npm install @mlc-ai/web-llm |
1 | import * as webllm from '@mlc-ai/web-llm'; |
initProgressCallback 是做用户体验的关键。模型文件几百 MB 到几个 GB,首次加载会持续几分钟,一定要做一个真实的下载进度条,否则用户面对白屏只会怀疑页面挂了。我一般把进度条做成两段式:前 5% 显示”初始化引擎”,后面显示”下载模型权重 x%”,并用 localStorage 记录”已加载过”状态,二次访问直接提示”正在从缓存加载,秒开”——WebLLM 会走浏览器 Cache API 缓存权重文件,第二次加载不用重新下载。
3.2 流式生成
Engine 就绪后,API 长得几乎和 OpenAI SDK 一样,我们上一篇处理 SSE 的经验直接复用:
1 | const chunks = await engine.chat.completions.create({ |
在 M3 Max 的 Chrome 里跑 Llama-3-8B 的 q4f32 量化版,我能观察到大概 20+ tokens/s,日常对话完全可用;在普通核显笔记本上会掉到 5 tokens/s 左右,能忍但不够爽。
3.3 一个容易忽略的点:页面生命周期
本地推理会持续占满 GPU 和大量内存,别在页面不可见时傻跑。我在实际项目里加了简单的调度:监听 document.visibilitychange,页面切后台就中断生成(WebLLM 的 engine.interruptGenerate()),回来再续。另外模型加载完之后引擎实例要全局复用,千万别每次对话都 CreateMLCEngine——重新加载一遍几个 GB 的权重,用户会当场去世。
4. Transformers.js:跑小模型不一定需要 WebGPU
如果需求只是分类、 embedding、语音识别这类轻量任务,上 8B 大模型属于高射炮打蚊子。Transformers.js(Hugging Face 官方)在浏览器里跑 ONNX 格式的小模型,几 MB 到几百 MB,CPU(WASM)就能跑,部分模型还能试试实验性的 WebGPU 后端:
1 | <script type="module"> |
我的典型用法:评论区的实时情感倾向小徽章、表单提交前的敏感词/情绪预检、站内搜索的本地 embedding 预处理。这类任务模型体积小、秒级响应、完全离线,用户体验和云端方案无异。
5. 性能与限制:泼一盆冷水
实测下来,端侧方案有几个绕不开的现实约束,做技术选型前必须想清楚:
- 内存/显存占用。7B 模型 4bit 量化后权重大约 4GB,加上运行时开销,浏览器里实际占用 6GB 起步。8GB 内存的机器会开始和系统抢内存,16GB 比较稳。移动端目前基本不用考虑 WebLLM 级别的模型。
- 模型下载体积。首次使用要下载几百 MB~几个 GB。我的做法是把”端侧 AI”做成渐进增强:默认云端,设置里提供”本地模式(需下载模型)”开关,让用户自己选。
- token 速度取决于用户硬件。云端方案速度是确定的(服务端 GPU 说了算),端侧方案速度由用户设备抽奖。对响应速度敏感的主流程别押注端侧。
- 浏览器兼容。Chrome/Edge 桌面版最稳;Safari 的 WebGPU 到 2024 年还偏早期;Firefox 在路上。特性检测 + 降级方案必不可少。
那么端侧是不是就没法用于生产?我的答案是:把它放进”端云混合”的架构里,让两类引擎各干各的擅长事。我给自己的产品做过一个实践分层:
1 | async function smartComplete(input) { |
分层的判断依据是三个问题:数据敏不敏感(敏感→端侧)、任务重不重(重→云端)、延迟要求高不高(要快→端侧)。让每一类请求自动落到合适的层上,用户无感,成本和隐私两头都照顾到了。至少目前,这是我试下来最省心的架构。
6. 展望:端侧 AI 的未来
往远了看,端侧 AI 的趋势比 WebLLM 本身更确定:Chrome 在推内建 AI(Gemini Nano 的实验性支持、Prompt API 早期预览),操作系统层面苹果的 Apple Intelligence、各家厂商的 NPU 也都在把小模型塞进设备。未来的前端工程师大概率会像今天处理响应式布局一样,处理”云侧/端侧混合推理”:敏感的、轻量的、离线的任务在端侧,重活儿在云端,而这一切的调度层,就写在我们手上。
浏览器跑大模型,2023 年还是实验室玩具,2024 年已经能做出可用的产品功能了。建议每个前端都把 WebLLM 的 Demo 跑一遍,亲眼看一个 8B 模型在自己的页面里吐字——看完你多半会开始盘算,手头哪些功能可以搬进端侧。
写在最后
从 WebGL 到 WebGPU,浏览器花了十来年从”画图”进化到”通用计算”;而从 WebGPU 到端侧 LLM,只用了一年。我们这代前端算是赶上了好时候:过去我们只负责把后端算好的数据”呈现”出来,现在算力直接长在用户设备上。下一篇我们回到云端,聊聊 Function Calling——怎么让大模型真正动手干活。