前言 上一篇写 DeepSeek 接入的时候,我们的对话助手已经能流畅地聊天了。但用了一段时间后我发现一个致命问题:你问它”我们团队的部署规范是什么”,它会一本正经地胡说八道——因为模型的训练数据里根本没有你们公司的文档。这就是所谓的大模型幻觉 :模型不是在”查资料”,而是在基于概率”续写”一段听起来很合理的话。
解决方案就是这两年特别火的 RAG(Retrieval-Augmented Generation,检索增强生成)。简单说,就是先从你自己的知识库里检索出相关内容,再把检索结果塞进 Prompt 里让模型回答。这篇我们就从前端工程师的视角,把 RAG 从原理到落地完整走一遍,最后用 Node 做一个能回答团队文档问题的问答服务。
1. 幻觉问题与 RAG 的基本原理 1.1 为什么大模型会”一本正经地胡说八道” 大模型的本质是一个基于上下文预测下一个 token 的概率模型。它没有”我不知道”的概念(除非被专门训练过),任何问题它都会尽量生成一段通顺的回答。当你问一个训练数据里不存在的事实,它就会用最”像答案”的方式编一个。
对个人聊天来说幻觉顶多算个乐子,但对企业知识库、客服系统、文档问答这类场景,幻觉是致命的。用户要的是有出处的准确答案 ,而不是天花乱坠的即兴创作。
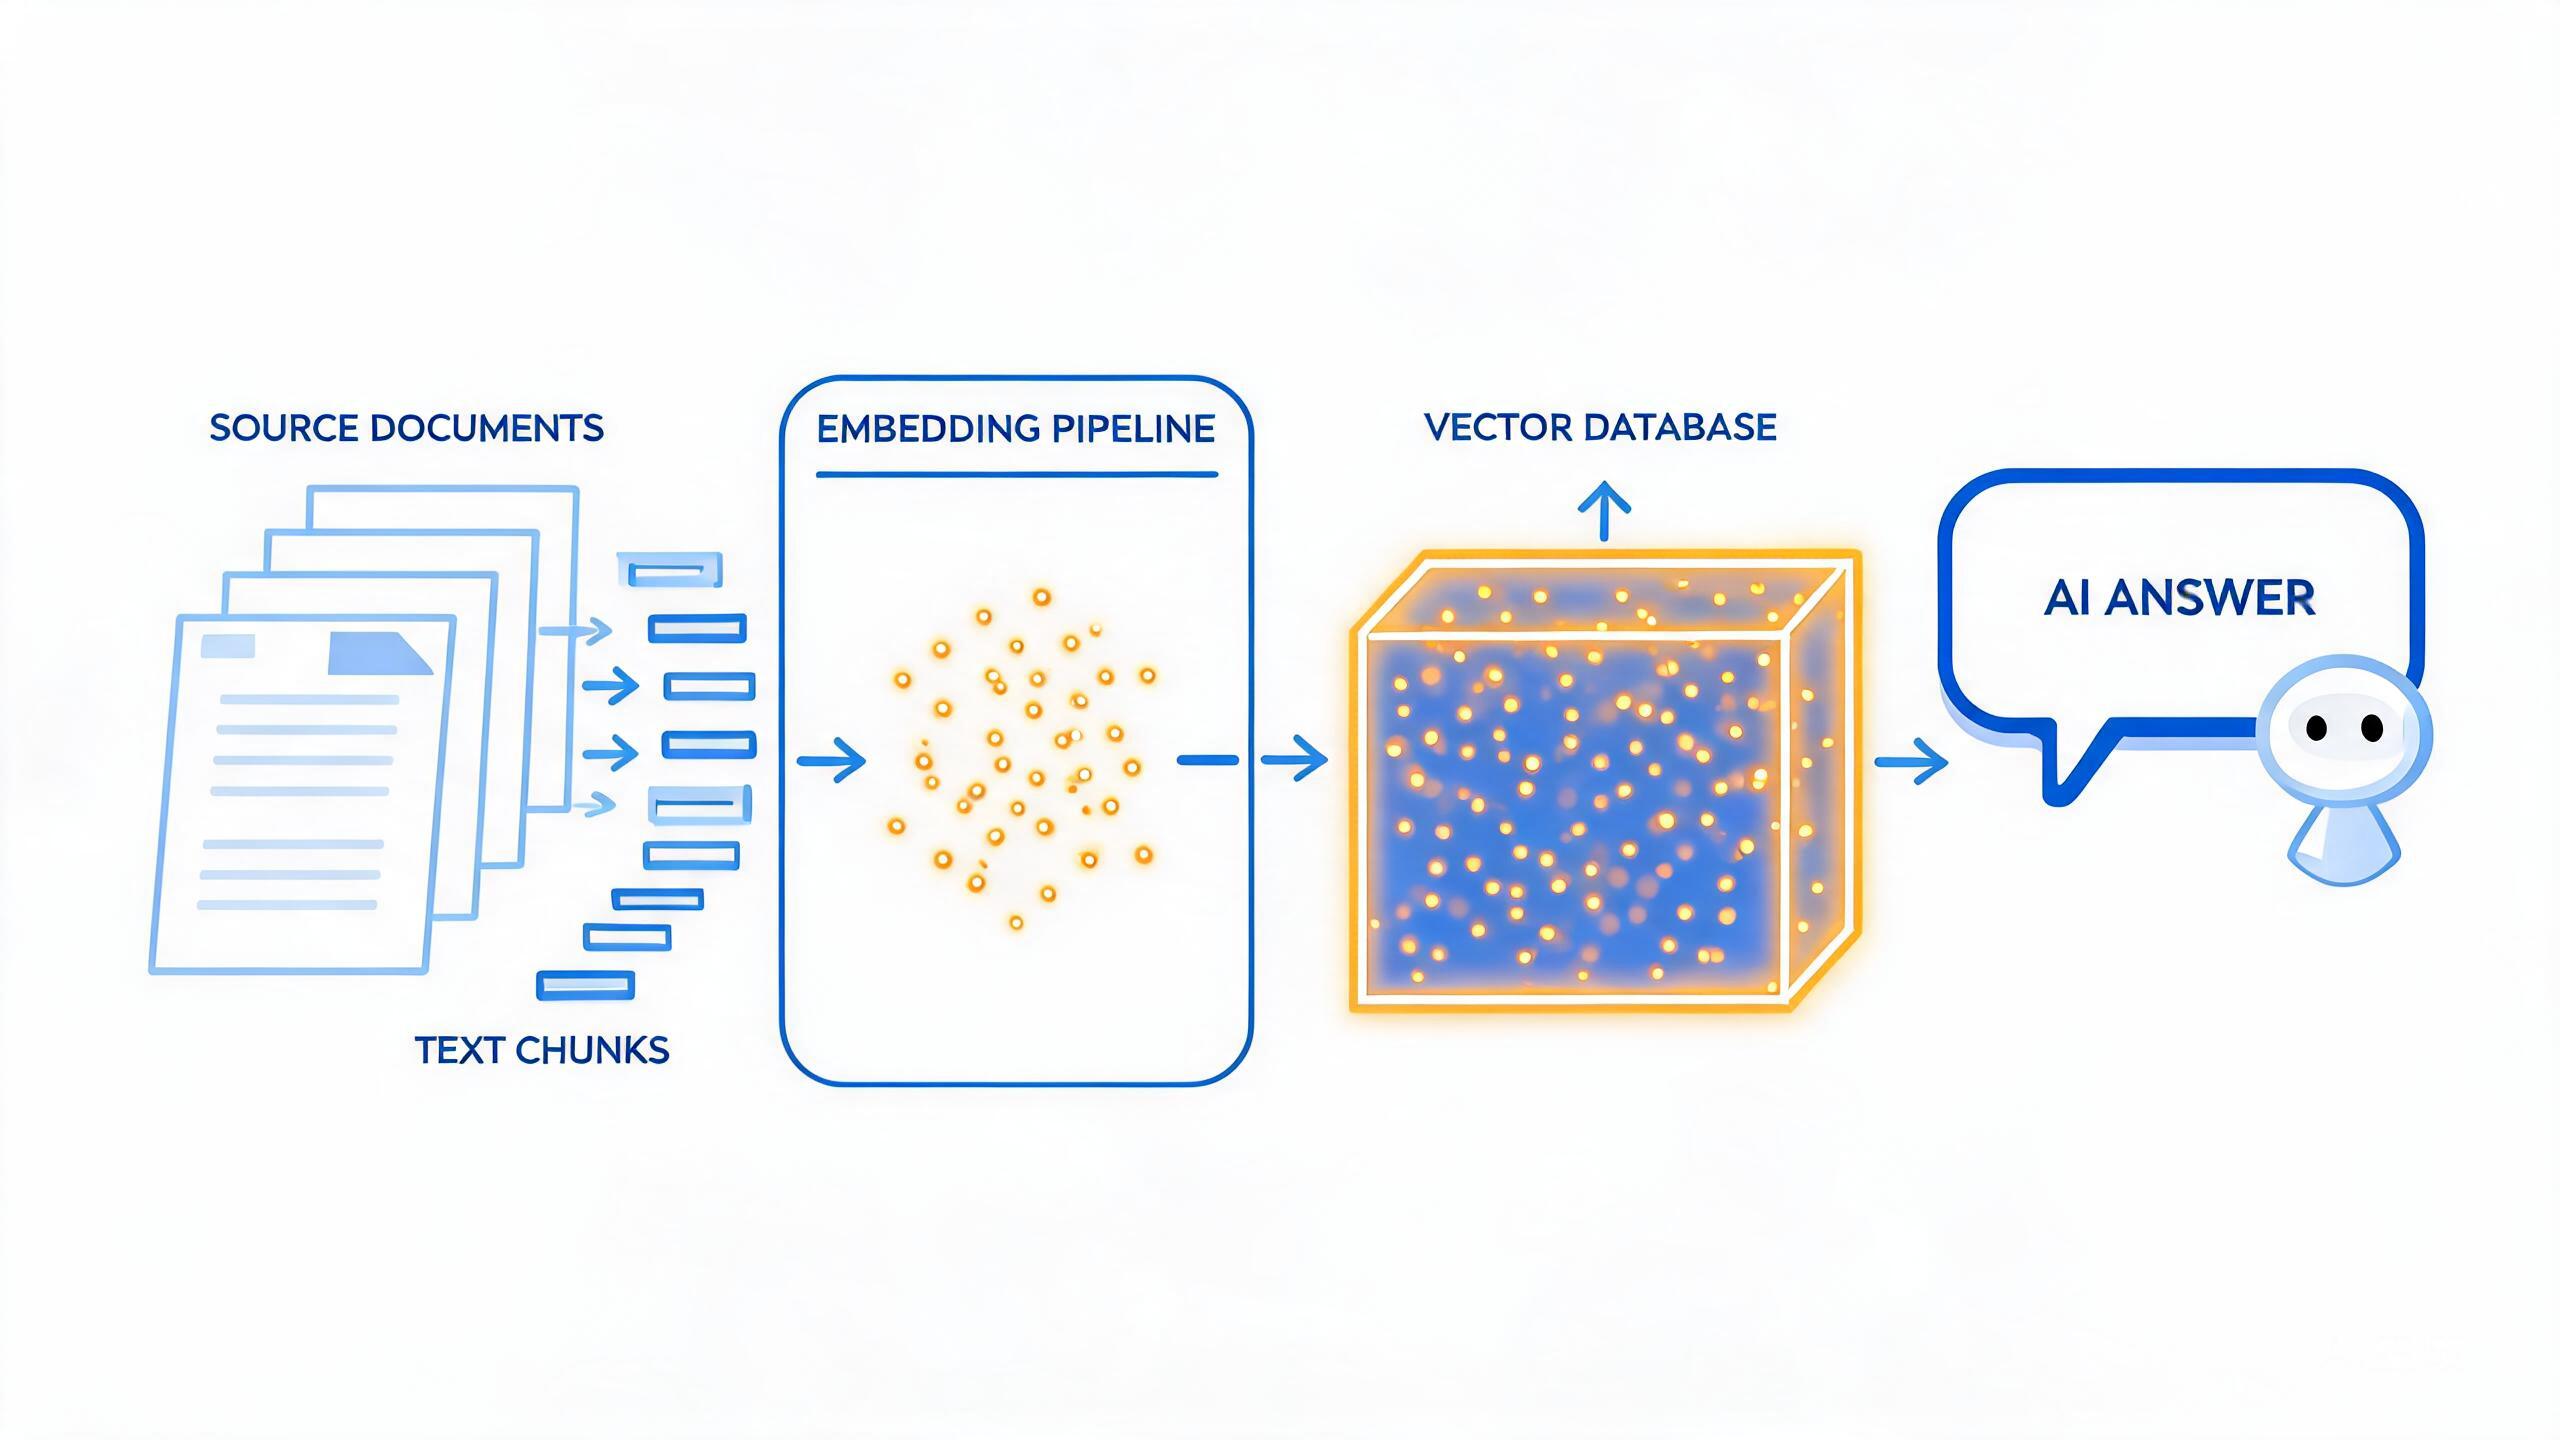
1.2 RAG:先检索,再生成 RAG 的思路非常朴素:既然模型不知道,那就把资料喂给它。整体流程分两个阶段:
离线索引阶段 (把文档”装进”向量库):
1
2
3
原始文档 → 切块(Chunking) → Embedding 模型 → 向量表示 → 存入向量库 │ └─ 每个块保留原文与元信息(来源、标题、位置)
在线问答阶段 (用户提问时):
1
2
3
用户提问 → 问题 Embedding → 向量库检索 Top-K 相似块 → 拼装 Prompt(系统指令 + 检索到的资料 + 问题) → LLM 基于资料生成回答 → 附带引用来源返回给用户
一句话:检索决定了回答质量的上限 。模型再强,如果你检索塞给它的资料是错的、不相关的,回答必然跑偏。所以 RAG 工程里大部分精力其实花在”怎么把相关内容找出来”上,而不是”怎么让模型说得好”上。
2. Embedding 通俗讲解
2.1 文本变向量:语义的坐标系 Embedding 就是把一段文本映射成一个固定长度的浮点数数组(比如 1536 维)。神奇的地方在于,语义相近的文本,向量在空间中的距离也相近。”如何部署前端项目”和”前端项目上线流程”字面上没几个相同的词,但它们的向量会挨得很近——因为 Embedding 模型在海量语料上学到了语义结构。
可以把它想象成给每段文字在一张巨大的”语义地图”上标一个坐标:猫和狗的坐标相近,猫和编译器的坐标相距十万八千里。检索时我们要做的,就是把用户的问题也标到这张地图上,然后找离它最近的几个文档块。
2.2 余弦相似度:判断两个向量”像不像” 衡量两个向量方向的相似度,最常用的是余弦相似度:夹角越小越相似,取值范围 [-1, 1],1 表示方向完全一致。用 JS 手写一个,几行就够了:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 function cosineSimilarity (a, b ) if (a.length !== b.length) { throw new Error ('向量维度不一致' ); } let dot = 0 ; let normA = 0 ; let normB = 0 ; for (let i = 0 ; i < a.length; i++) { dot += a[i] * b[i]; normA += a[i] * a[i]; normB += b[i] * b[i]; } const denom = Math .sqrt(normA) * Math .sqrt(normB); return denom === 0 ? 0 : dot / denom; } const query = [0.9 , 0.1 , 0.2 ]; const doc1 = [0.85 , 0.15 , 0.18 ]; const doc2 = [0.1 , 0.9 , 0.3 ]; console .log(cosineSimilarity(query, doc1)); console .log(cosineSimilarity(query, doc2));
生产环境里我们不会自己手算——向量库(Milvus、Qdrant、pgvector 等)内部用更高效的 ANN(近似最近邻)算法做检索。但对于几千个块以内的中小规模知识库,内存里暴力算余弦相似度完全够用 ,下面实战就是这么干的。
3. 实战:Node 端给团队文档做问答 我们的目标:把团队的 Markdown 文档做成一个问答服务,用 OpenAI 的 embedding API 做向量化,用内存数组做向量索引,最后调 Chat API 生成回答。
3.1 切块策略:RAG 的第一道坎 切块(Chunking)是最容易被低估的环节。切太大,检索粒度粗,一个块里混了多个主题,还会挤占 Prompt 预算;切太小,上下文碎片化,”上一步说了啥”丢了,回答就缺信息。
我实践的起点策略:按标题层级切块 + 500 字符左右为界 + 相邻块重叠 50 字符 。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
const md = require ('markdown-it' )();function chunkMarkdown (content, maxLen = 500 , overlap = 50 ) const sections = content.split(/^(#{2,3} .+)$/m ); const chunks = []; let currentTitle = '' ; for (const part of sections) { if (/^#{2,3} / .test(part)) { currentTitle = part.replace(/^#+ / , '' ).trim(); continue ; } const text = part.trim(); if (!text) continue ; let start = 0 ; while (start < text.length) { let end = Math .min(start + maxLen, text.length); if (end < text.length) { let lastStop = -1 ; for (const s of ['。' , '?' , '!' ]) lastStop = Math .max(lastStop, text.lastIndexOf(s, end)); if (lastStop > start + maxLen * 0.5 ) end = lastStop + 1 ; } const slice = text.slice(start, end).trim(); if (slice) { chunks.push({ title : currentTitle, content : slice }); } if (end >= text.length) break ; start = end - overlap; } } return chunks; }
注意 title 会作为元信息跟着块走,后面拼 Prompt 和展示引用来源都要用。
3.2 构建 Embedding 与内存向量索引 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 const OpenAI = require ('openai' );const fs = require ('fs' );const path = require ('path' );const client = new OpenAI({ apiKey: process.env.OPENAI_API_KEY, baseURL: process.env.OPENAI_BASE_URL, }); async function embed (texts ) const res = await client.embeddings.create({ model: 'text-embedding-3-small' , input: texts, }); return res.data.map((d ) => d.embedding); } async function buildIndex (docsDir ) const files = fs.readdirSync(docsDir).filter((f ) => f.endsWith('.md' )); const chunks = []; for (const file of files) { const raw = fs.readFileSync(path.join(docsDir, file), 'utf-8' ); for (const c of chunkMarkdown(raw)) { chunks.push({ ...c, source : file }); } } const BATCH = 64 ; for (let i = 0 ; i < chunks.length; i += BATCH) { const batch = chunks.slice(i, i + BATCH); const vectors = await embed(batch.map((c ) => `${c.title} \n${c.content} ` )); batch.forEach((c, j ) => { c.vector = vectors[j]; }); console .log(`已索引 ${Math .min(i + BATCH, chunks.length)} /${chunks.length} 块` ); } return chunks; } module .exports = { buildIndex, embed };
把 embedding 的输入加上 title 是个小技巧:标题是块主题最强的信号,混进去能明显提升检索命中。
3.3 Top-K 检索与拼装 Prompt 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 const { cosineSimilarity } = require ('./similarity' );const { embed } = require ('./embedding' );async function answer (question, index, { topK = 4 , chatModel = 'gpt-3.5-turbo' } = {} ) const [queryVec] = await embed([question]); const hits = index .map((c ) => ({ ...c, score : cosineSimilarity(queryVec, c.vector) })) .sort((a, b ) => b.score - a.score) .slice(0 , topK); const context = hits .map((h, i ) => `[${i + 1 } ] 来源《${h.source} 》 - ${h.title} \n${h.content} ` ) .join('\n\n---\n\n' ); const systemPrompt = `你是团队知识库助手。请仅依据下面的资料回答问题,并在回答末尾用 [n] 标注引用了哪条资料。如果资料不足以回答,直接说"知识库中没有找到相关内容",不要编造。 === 参考资料 === ${context} === 资料结束 ===` ; const stream = await client.chat.completions.create({ model: chatModel, messages: [ { role : 'system' , content : systemPrompt }, { role : 'user' , content : question }, ], stream: true , }); return { stream, hits }; } app.get('/api/ask' , async (req, res) => { const { stream, hits } = await answer(req.query.q, globalIndex); res.setHeader('Content-Type' , 'text/event-stream' ); for await (const chunk of stream) { const delta = chunk.choices[0 ]?.delta?.content; if (delta) res.write(`data: ${JSON .stringify({ delta })} \n\n` ); } res.write(`data: ${JSON .stringify({ sources: hits.map((h) => ({ source: h.source, title: h.title, score: h.score })) })} \n\n` ); res.end(); });
Prompt 里有三个关键约束:限定只依据资料回答 、要求标注引用 、资料不足时明确说找不到 。最后一条尤其重要——它是压制幻觉的保险丝,宁可让用户”没查到”,也不能让模型开编。
3.4 前端展示引用来源 回答结束后,把 SSE 里最后那条 sources 消息渲染出来。可以在回答下方加一个”引用来源”折叠区,点击可跳转到原文档对应位置:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
function SourceList({ sources }: { sources: Source[] }) { if (!sources?.length) return null; return ( <details className="mt-3 text-sm text-gray-500"> <summary>引用来源({sources.length})</summary> <ul className="mt-2 space-y-1"> {sources.map((s, i) => ( <li key={i}> [{i + 1}]{' '} <a href={`/docs/${s.source}`} className="underline hover:text-blue-500"> {s.source} · {s.title} </a> <span className="ml-2">相关度 {(s.score * 100).toFixed(1)}%</span> </li> ))} </ul> </details> ); }
有来源标注之后,整个系统的可信度完全不一样了。用户可以点进去核对原文,AI 从”玄学黑盒”变成了”可验证的检索器 + 总结器”。
4. 踩坑记录 切块大小没有银弹。 我一开始贪心用 1000 字符,结果 FAQ 类文档多个问答挤在一个块里,检索出来一半是无关内容;后来切到 200 又太碎。500 上下、按标题先切是比较稳的起点,但一定要根据自己的文档形态调,最好准备一组标准问题做评测集,改动策略后跑一遍对比命中率。
中文分词不是必须,但中文标点要注意。 Embedding 模型本身理解中文,不需要自己分词。但切块时按句号断句,记得把中文句号(。)、问号(?)都纳入断点,我第一版只考虑英文句点,切出来的块经常半句话。
成本控制靠两点:缓存 embedding + 选对模型。 embedding API 按输入 token 计费,但文档索引是一次性成本,真正反复发生的是问题向量化 ——每次提问只 embed 一句问题,成本几乎可以忽略。真正烧钱的是 Chat 模型,塞进 Prompt 的资料越多越贵,所以 Top-K 别贪多(4 条左右),并在块上做去重。另外给索引加个文档内容的 hash 缓存,文档没变就跳过重新 embedding,能省下大量索引费用。
内存索引的边界。 几千个块、1536 维浮点数,内存占用大概几十 MB,Node 单进程毫无压力。但如果块数到了十万级,就该上真正的向量库了,或者至少做一层向量量化。先简单后复杂,别一上来就自建 Milvus 集群。
写在最后 RAG 是我目前见过性价比最高的 LLM 落地模式:不需要训练模型、不需要海量数据,把”检索”这个前端工程师再熟悉不过的老本行和 LLM 拼起来,就能做出真正可用的知识库应用。这篇文章里的内存索引版本,大概两百行代码就能跑起来,非常适合作为你们团队 AI 应用的第一个试点。
当然,这只是主干:混合检索(向量 + 关键词)、重排序(Rerank)、查询改写都有得玩,但先把”切块 → Embedding → 检索 → 注入”这条主干跑通,等评测集告诉你哪里不行再上进阶手段也不迟。下一篇我们聊聊 Function Calling,让模型从”会说话”变成”会干活”。