前言
2023 年我写《ChatGPT API 之初体验》那会儿,圈内讨论的还全是 Prompt 工程:怎么写一句”你是一位资深专家”、怎么加一句”让我们一步一步思考”、怎么用 few-shot 举例子。那时候模型窗口只有 4K、8K token,一次能塞进去的信息极其有限,”把一句话说到点子上”就是全部功夫。
三年过去,情况彻底变了。2026 年的模型,200K 上下文是标配,长上下文模型普遍到了百万级 token。窗口不再稀缺,新的问题反而冒出来了:上下文里塞的东西越多,模型表现并不见得更好,甚至越来越笨。
于是行业里出现了一个新词:Context Engineering(上下文工程)。它回答的问题不再是”这句话怎么写”,而是”在每次模型调用之前,往上下文里放什么、不放什么、以什么结构放”。最近半年我在一个多轮客服 Agent 项目里被这个问题反复毒打,这篇文章就把踩过的坑和沉淀的做法一次性聊清楚。
1. 从 Prompt 工程到 Context 工程
1.1 窗口变大之后,问题变了
Prompt 工程时代的假设是:上下文很小,所以每一句话都要精雕细琢。而上下文工程的假设是:上下文很大,大到你可以把整个”工作环境”都搬进去——文档、工具结果、用户偏好、历史对话——但大不等于可以乱放。
打个比方:Prompt 工程像是琢磨”这句话怎么说好听”,Context 工程像是给一位新同事布置办公桌——桌上放哪些资料、什么资料放在最顺手的位置、过期的文件要不要扔掉。桌子乱七八糟堆满东西,再聪明的同事也会效率骤降,模型同理。
1.2 Prompt 只是上下文的一小部分
把一次典型 Agent 调用的上下文拆开看,你会发现 Prompt 占比其实很小:
1 | [System] 你是订单客服助手,规则如下…… ← prompt 工程,占比可能不到 10% |
真正决定模型发挥水平的,是这五块内容的组织方式。工程师能”工程”的,也正是这五块。这就是我理解的上下文工程:它不是写文案,而是一种信息架构工作。对前端同学来说,这个味道是不是很熟悉?后面第 5 节我会展开这个类比。
2. 上下文的五大构成
2.1 System Prompt:宪法而不是说明书
System Prompt 定义角色、边界和输出格式。我的经验是:规则越少越好,但每条都必须是”硬约束”。把几百条注意事项全塞进去,模型一条也记不住,这本身就是一种上下文污染。
2.2 工具结果:最容易失控的部分
Agent 一跑起来,工具返回值是最膨胀的内容。一次 search_order 返回 50KB 的 JSON,三轮下来上下文就被工具结果淹没了。工具结果必须裁剪,第 3.2 节我会给具体做法。
2.3 检索内容:RAG 的质量决定上限
RAG 检索回来的片段质量参差,8 段里混着 5 段不相关的,模型反而会被带偏。检索内容进上下文之前,最好再做一次相关性过滤或重排。
2.4 记忆:跨会话的长期信息
用户偏好、历史结论、已确认的事实。记忆的难点不在写入而在”过期”:用户半年前说喜欢邮件通知,上周改成了短信,旧记忆不清理就是定时炸弹。
2.5 历史消息:多轮对话的滚雪球
多轮 Agent 的历史消息是线性增长的,而大量轮次里的信息其实已经过时(”刚才那个报错已修复”)。历史必须压缩,这是下一个重点。
3. 实战:给一个多轮 Agent 瘦身
我们的客服 Agent 原始版本很朴素:历史消息全量保留、工具结果原样进上下文。跑 20 轮之后上下文逼近 80K token,响应变慢、费用飙升,模型还开始”忘了”最开始的用户诉求。下面是三个逐步优化手段。
3.1 历史消息:滑动窗口 + 摘要压缩
思路:保留最近 N 条原文(保证近期细节),更早的部分让模型压缩成一条摘要,替换掉原始消息。
1 | // history-compactor.ts |
三个实战注意点:
- 压缩放后台异步做,别阻塞当前轮次。当前轮先用旧历史顶上,压完再替换。
- 摘要要标成独立的
summary角色,并在内容里注明”细节已省略”,否则模型会以为摘要就是全部事实,丢失时反而硬编。 - 压缩本身也是一次模型调用,有成本。我们的做法是每新增两条消息才触发一次检查,且摘要调用用便宜的小模型。
3.2 工具结果裁剪:截断 + 投影
第一层是通用截断,保留头尾(很多日志关键信息在开头和结尾):
1 | // trim.ts —— 通用工具结果截断 |
第二层更有效:投影(projection)。与其让模型读 50KB 的订单 JSON,不如只保留模型任务需要的字段:
1 | // 投影:把 50KB 的订单对象收敛成模型真正需要的几百字节 |
白名单式投影还有个隐性好处:敏感字段(手机号、地址详情)根本不进上下文,天然降低了数据泄漏面。
3.3 结构化上下文模板
零散拼接的上下文,模型读起来像一锅粥。我们的最终形态是用固定模板把上下文分区(XML 标签分区是目前效果最稳的方式之一):
1 | <context> |
分区的好处:模型对”这一块是什么性质的信息”判断更准,引用时不容易张冠李戴;同时我们可以在代码层面按区做预算控制:比如 retrieved_docs 最多占 4K token,超了就取 top 段落。
4. 踩坑:上下文污染与注意力稀释
4.1 无关信息真的会让模型变笨
一个反直觉的事实:上下文里的无关信息不只是浪费 token,而是实打实地拉低回答质量。学术界叫 Lost in the Middle:模型对上下文开头和结尾的内容注意力最强,中间部分最容易被忽略。
我们踩过的实例:知识库检索召回 8 段文档,其中 5 段是另一个产品线的旧文档。模型回答时把两个产品的退款政策混在一起,一本正经地胡说八道。修复方案是在检索层加相关性阈值 + 重排,宁可只给 2 段高相关的。
4.2 过期信息比没有信息更糟
更阴险的坑是”过期信息”。我们的 Agent 曾把三个月前的价格表(来自一次缓存的工具结果)一直留在多轮上下文里,之后用户无论怎么问,模型都坚持报旧价格——因为上下文里白纸黑字写着,模型对上下文的信任度高于它的参数知识。
防御原则:
- 宁缺毋滥:不确定相关性的内容不进上下文。
- 及时作废:失败的、被推翻的工具结果要显式标记”已失败/已过时,勿参考”,最好直接移除。
- 重要信息放头尾:关键约束写进 System Prompt(开头)或最终指令(结尾),别埋在中间。
5. 给前端的启示:上下文即新的”状态管理”
写到这里,做了这么多年前端的我越来越觉得:上下文工程本质上是新一轮状态管理。对照着看几乎是一一映射:
| React / 状态管理世界 | 上下文世界 |
|---|---|
| props / 一次性消息 | user message |
| 全局 store | System Prompt + 长期记忆 |
| 状态归一化、派生数据 | 工具结果投影、裁剪 |
| 缓存失效 | 过期信息清理 |
| 组件渲染优先级 | token 预算与优先级装填 |
| 重渲染范围控制 | 上下文分区与隔离 |
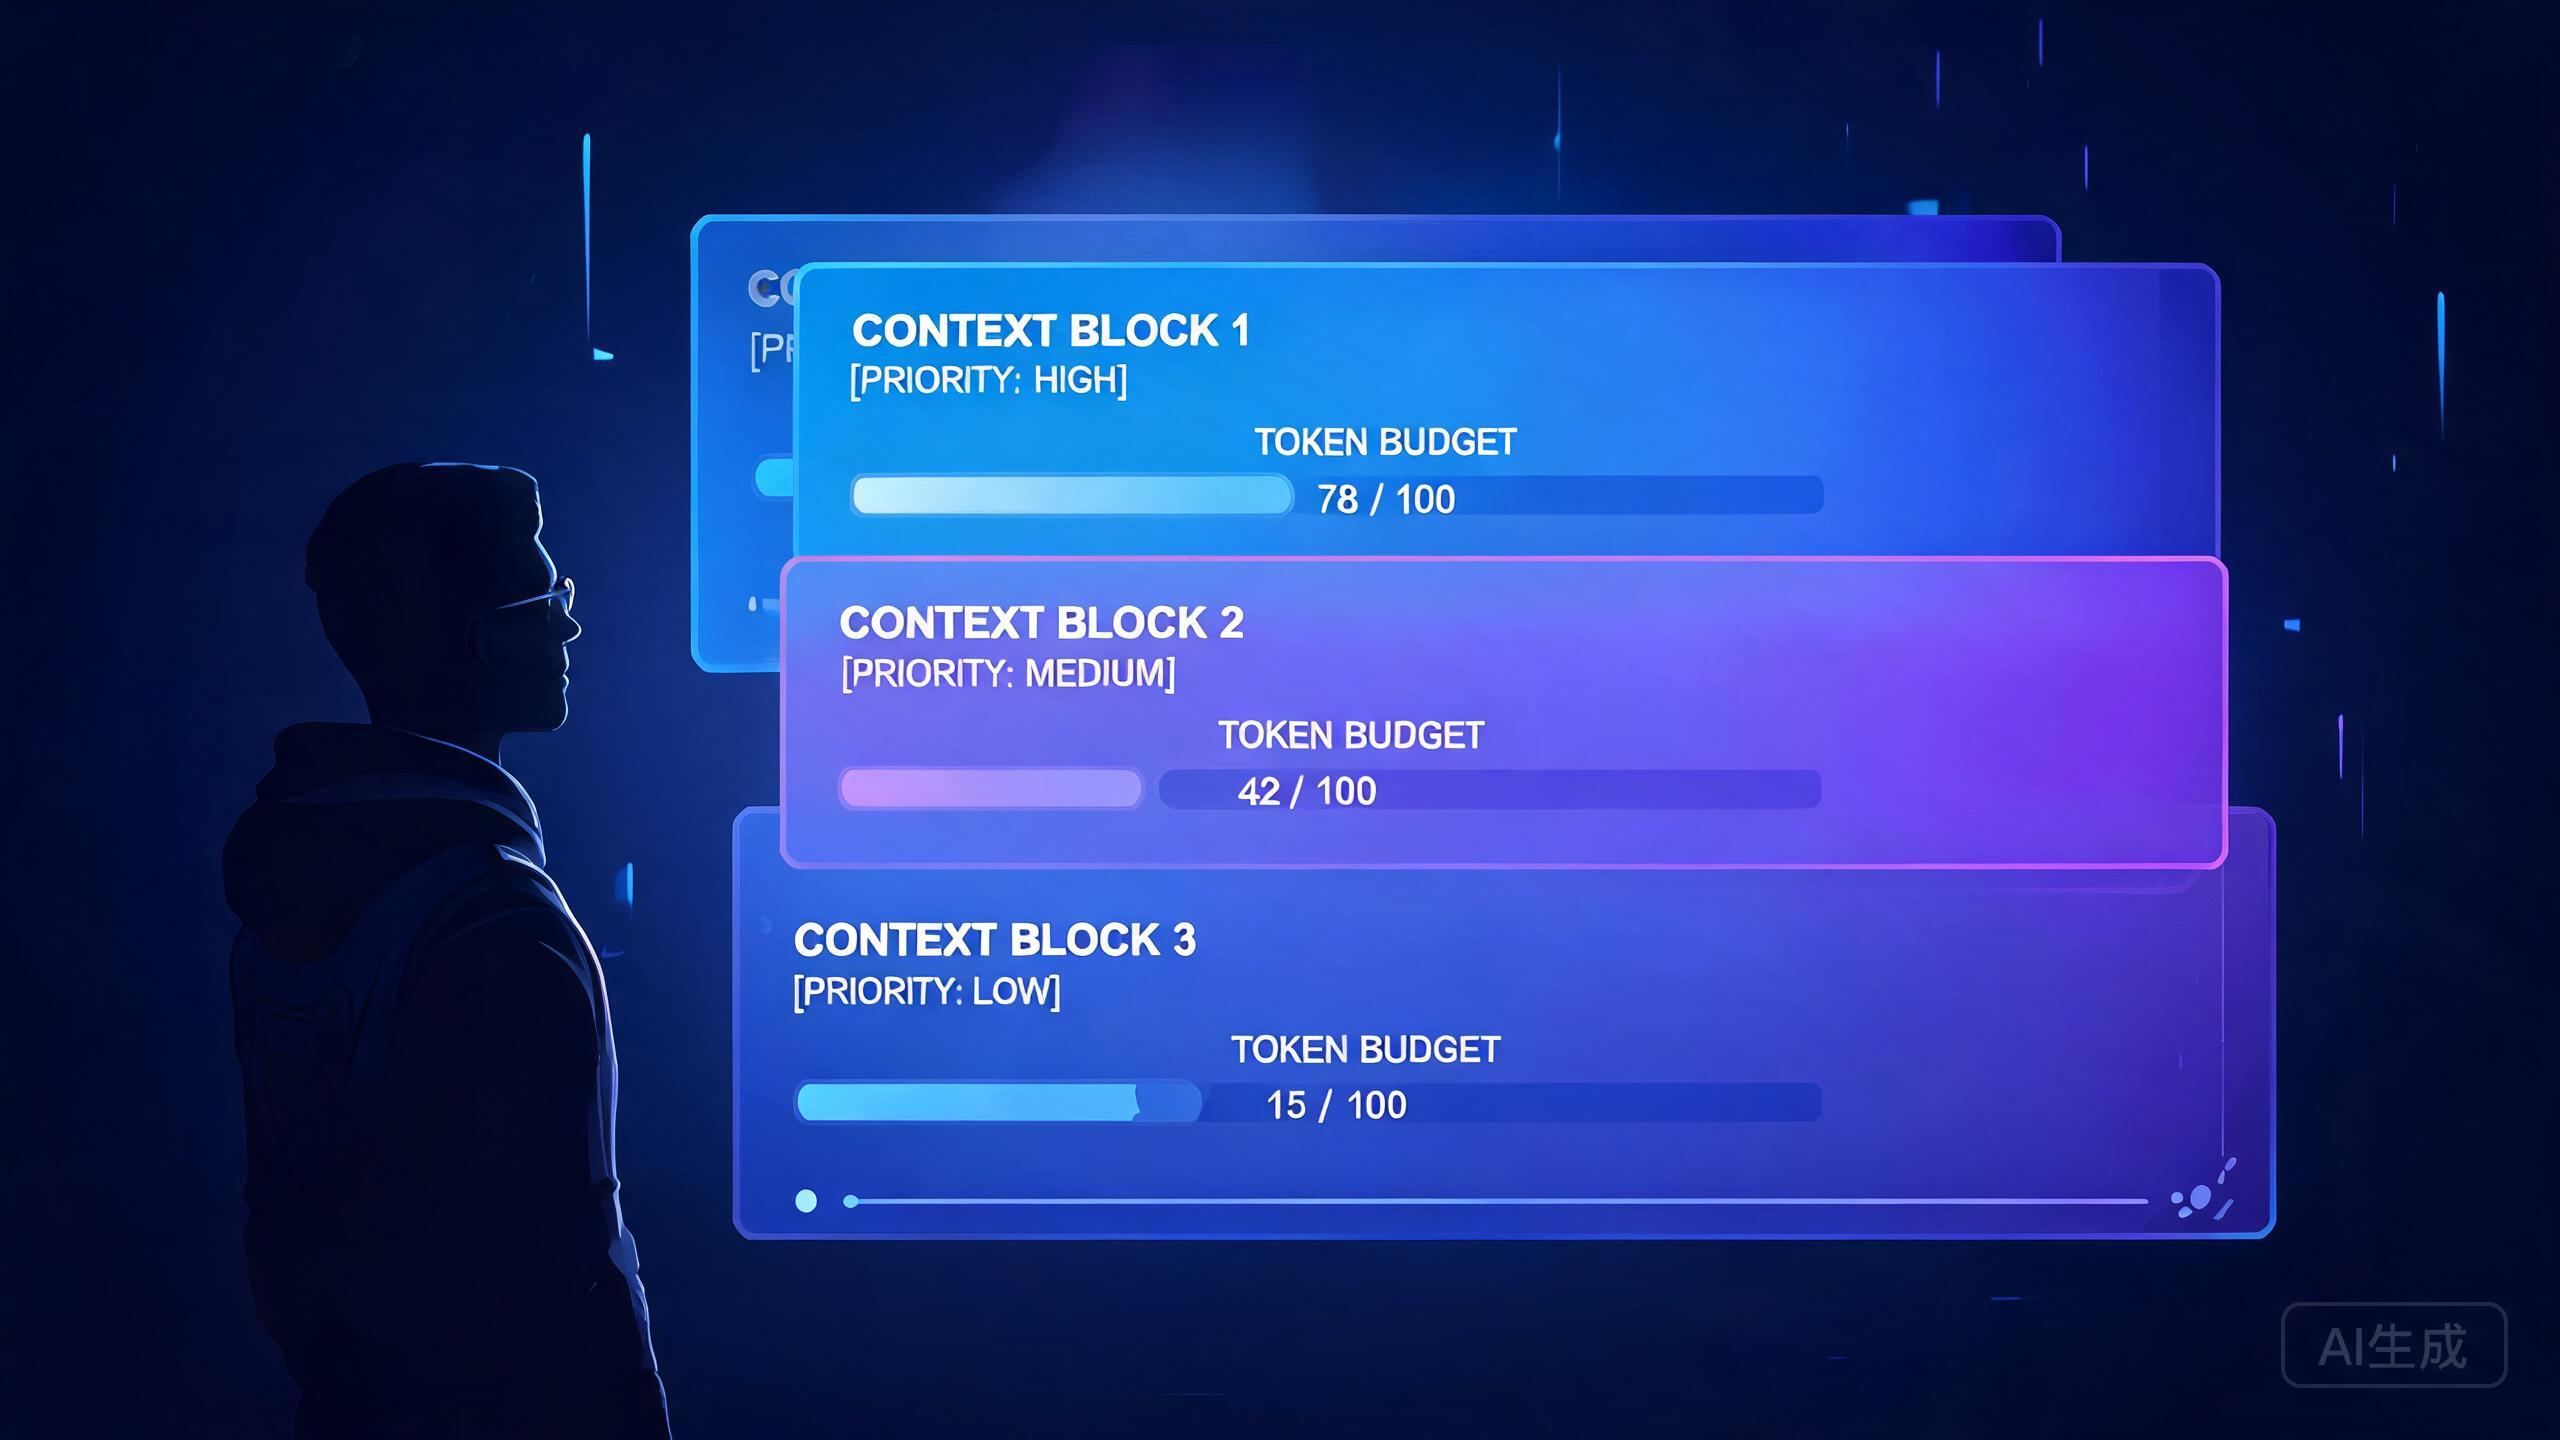
于是我们照着 store 的思路写了一个上下文管理器:每个信息块带优先级和 token 估算,按预算装填,超预算的低优先级块直接丢弃,和 React 里”有限资源下的渲染调度”是同一个思想:
1 | // context-manager.ts —— 把上下文当成一个 store 来管理 |
这个设计有三个要点:token 预算(任何信息进上下文都要”付租金”)、优先级装填(资源紧张时先丢什么)、声明顺序输出(装填按优先级、输出按语义顺序,两回事)。把这三件事想清楚,你的 Agent 上下文就从”一锅粥”变成了”一个有纪律的 store”。
写在最后
从 Prompt 工程到上下文工程,措辞变了,工程重心也跟着迁移:模型能力越强,”喂给它什么”就越比”怎么问它”重要。这套活儿对前端不陌生:我们花了十年学会管理浏览器里的状态,现在只是把同一套功力用进模型窗口。
下一步我打算把 ContextManager 和 HistoryCompactor 抽成独立的开源小库,跑通真实项目后再写一篇续集。眼下还有一个没拿准的问题:历史摘要压得太狠,用户早期随口提过的偏好会不会跟着丢?小库开源前,我得先拿几条真实会话验证一遍。