前言
过去三个月,我的朋友圈几乎被 ChatGPT 刷屏了。有人拿它写周报,有人拿它改简历,还有人已经用它写起了代码。作为一个写了十年前端的老兵,我承认一开始是带着看热闹的心态去注册账号的——结果这一玩,就再也停不下来了。
3 月 1 号 OpenAI 终于放出了 ChatGPT 的官方 API(gpt-3.5-turbo),价格比原来的 Completion 接口便宜了一个数量级。这对我们前端工程师来说是个重要节点:以前只能网页上玩,现在可以真正把大模型的能力接到自己的产品里了。这篇文章记录我这几天的接入过程,包括 API 的核心概念、完整的调用代码、多轮对话的实现原理,以及第一个大坑——API key 的安全问题。
1. 为什么这次不一样
ChatGPT 火了之后,我一直在想一个问题:它和我们调过的那些”智能接口”到底有什么区别?试了几天之后我的结论是:这是第一个可以用人话对话、且对话质量超过大多数人的机器。以前的 NLP 接口是”功能机”——情感分析、实体识别、意图分类,一个接口只干一件事;而 ChatGPT 是”智能机”,一个接口可以干所有事,你只需要用自然语言描述需求。
OpenAI 这次开放的 API 有几个关键信息:
- 模型名是
gpt-3.5-turbo,就是网页版 ChatGPT 背后同一个模型; - 计费按 token 算,$0.002 / 1K tokens,比
text-davinci-003便宜 10 倍; - 接口形式从”一句话补全”(Completion)变成了”多轮对话”(Chat),这个变化对我们前端来说影响很大,后面细说。
说白了,OpenAI 是把网页版 ChatGPT 同款能力做成了标准 REST 接口,任何人都可以在自己的应用里嵌一个”小 ChatGPT”。这让我想起 2008 年第一次调 iPhone SDK 时的感觉——平台级的窗口正在打开。
2. API 核心概念
第一次打开文档的时候我也懵了一会儿,因为 messages 这个结构和我以前的认知不太一样。花一个小时读完文档后,我把核心概念梳理成了下面几个。
2.1 一次”对话补全”请求长什么样
1 | POST https://api.openai.com/v1/chat/completions |
2.2 四个必须理解的概念
model:模型名。目前就写 gpt-3.5-turbo,这也是当前唯一开放的 Chat 模型(gpt-4 传闻满天飞,但还没影)。
messages:一个数组,是整个接口的灵魂。每个元素有 role 和 content 两个字段,role 有三种取值:
system:给 AI 的人设/规则,相当于”初始化指令”,比如”你是一个只会输出 JSON 的翻译机器”;user:用户说的话;assistant:AI 的历史回答。
temperature:温度,0 到 2 之间的浮点数。越低输出越确定、越保守;越高越随机、越有”创造力”。我的经验值:做代码生成、数据抽取用 0 到 0.3,写文案、头脑风暴用 0.8 到 1。
max_tokens:本次回答最多生成多少 token,防止失控烧钱。注意它是”回答”的上限,不是整个上下文的上限。
3. 用 fetch 调一下
概念讲完,上代码。前端工程师的母语是 fetch,先来个最朴素的版本:
1 | async function askChatGPT(question) { |
返回结构里最关键的是 choices[0].message.content,就是 AI 的回答。另外 data.usage 里有 prompt_tokens、completion_tokens、total_tokens 三个字段,这是记账用的,调试时打印出来能帮你建立 token 的直觉。
跑通这行代码的那一刻我确实有点激动:十年前我们调的是浏览器 DOM API,现在调的是”智能”本身。
3.1 别忽略返回里的两个字段
除了回答正文,返回 JSON 里还有两个不起眼的字段。一个是 finish_reason:值为 stop 表示模型自然说完,值为 length 说明是撞上了 max_tokens 上限被拦腰截断——后者意味着内容不完整,需要你处理续写或者调大参数。我在调试一个长文摘要脚本时就因为忽略它,拿到过一堆”半句话”,排查了半天还以为是网络问题。另一个是 usage,前面提过它负责记账,把它打点到日志里,上线后能清楚地看到每类请求的真实成本,做产品决策时心里有底。它们看着简单,但养成看它们的习惯,能省掉很多莫名其妙的排查时间。
4. 多轮对话:它其实是无状态的
这是我这次学到的最重要的一个知识点,一开始我完全理解错了。
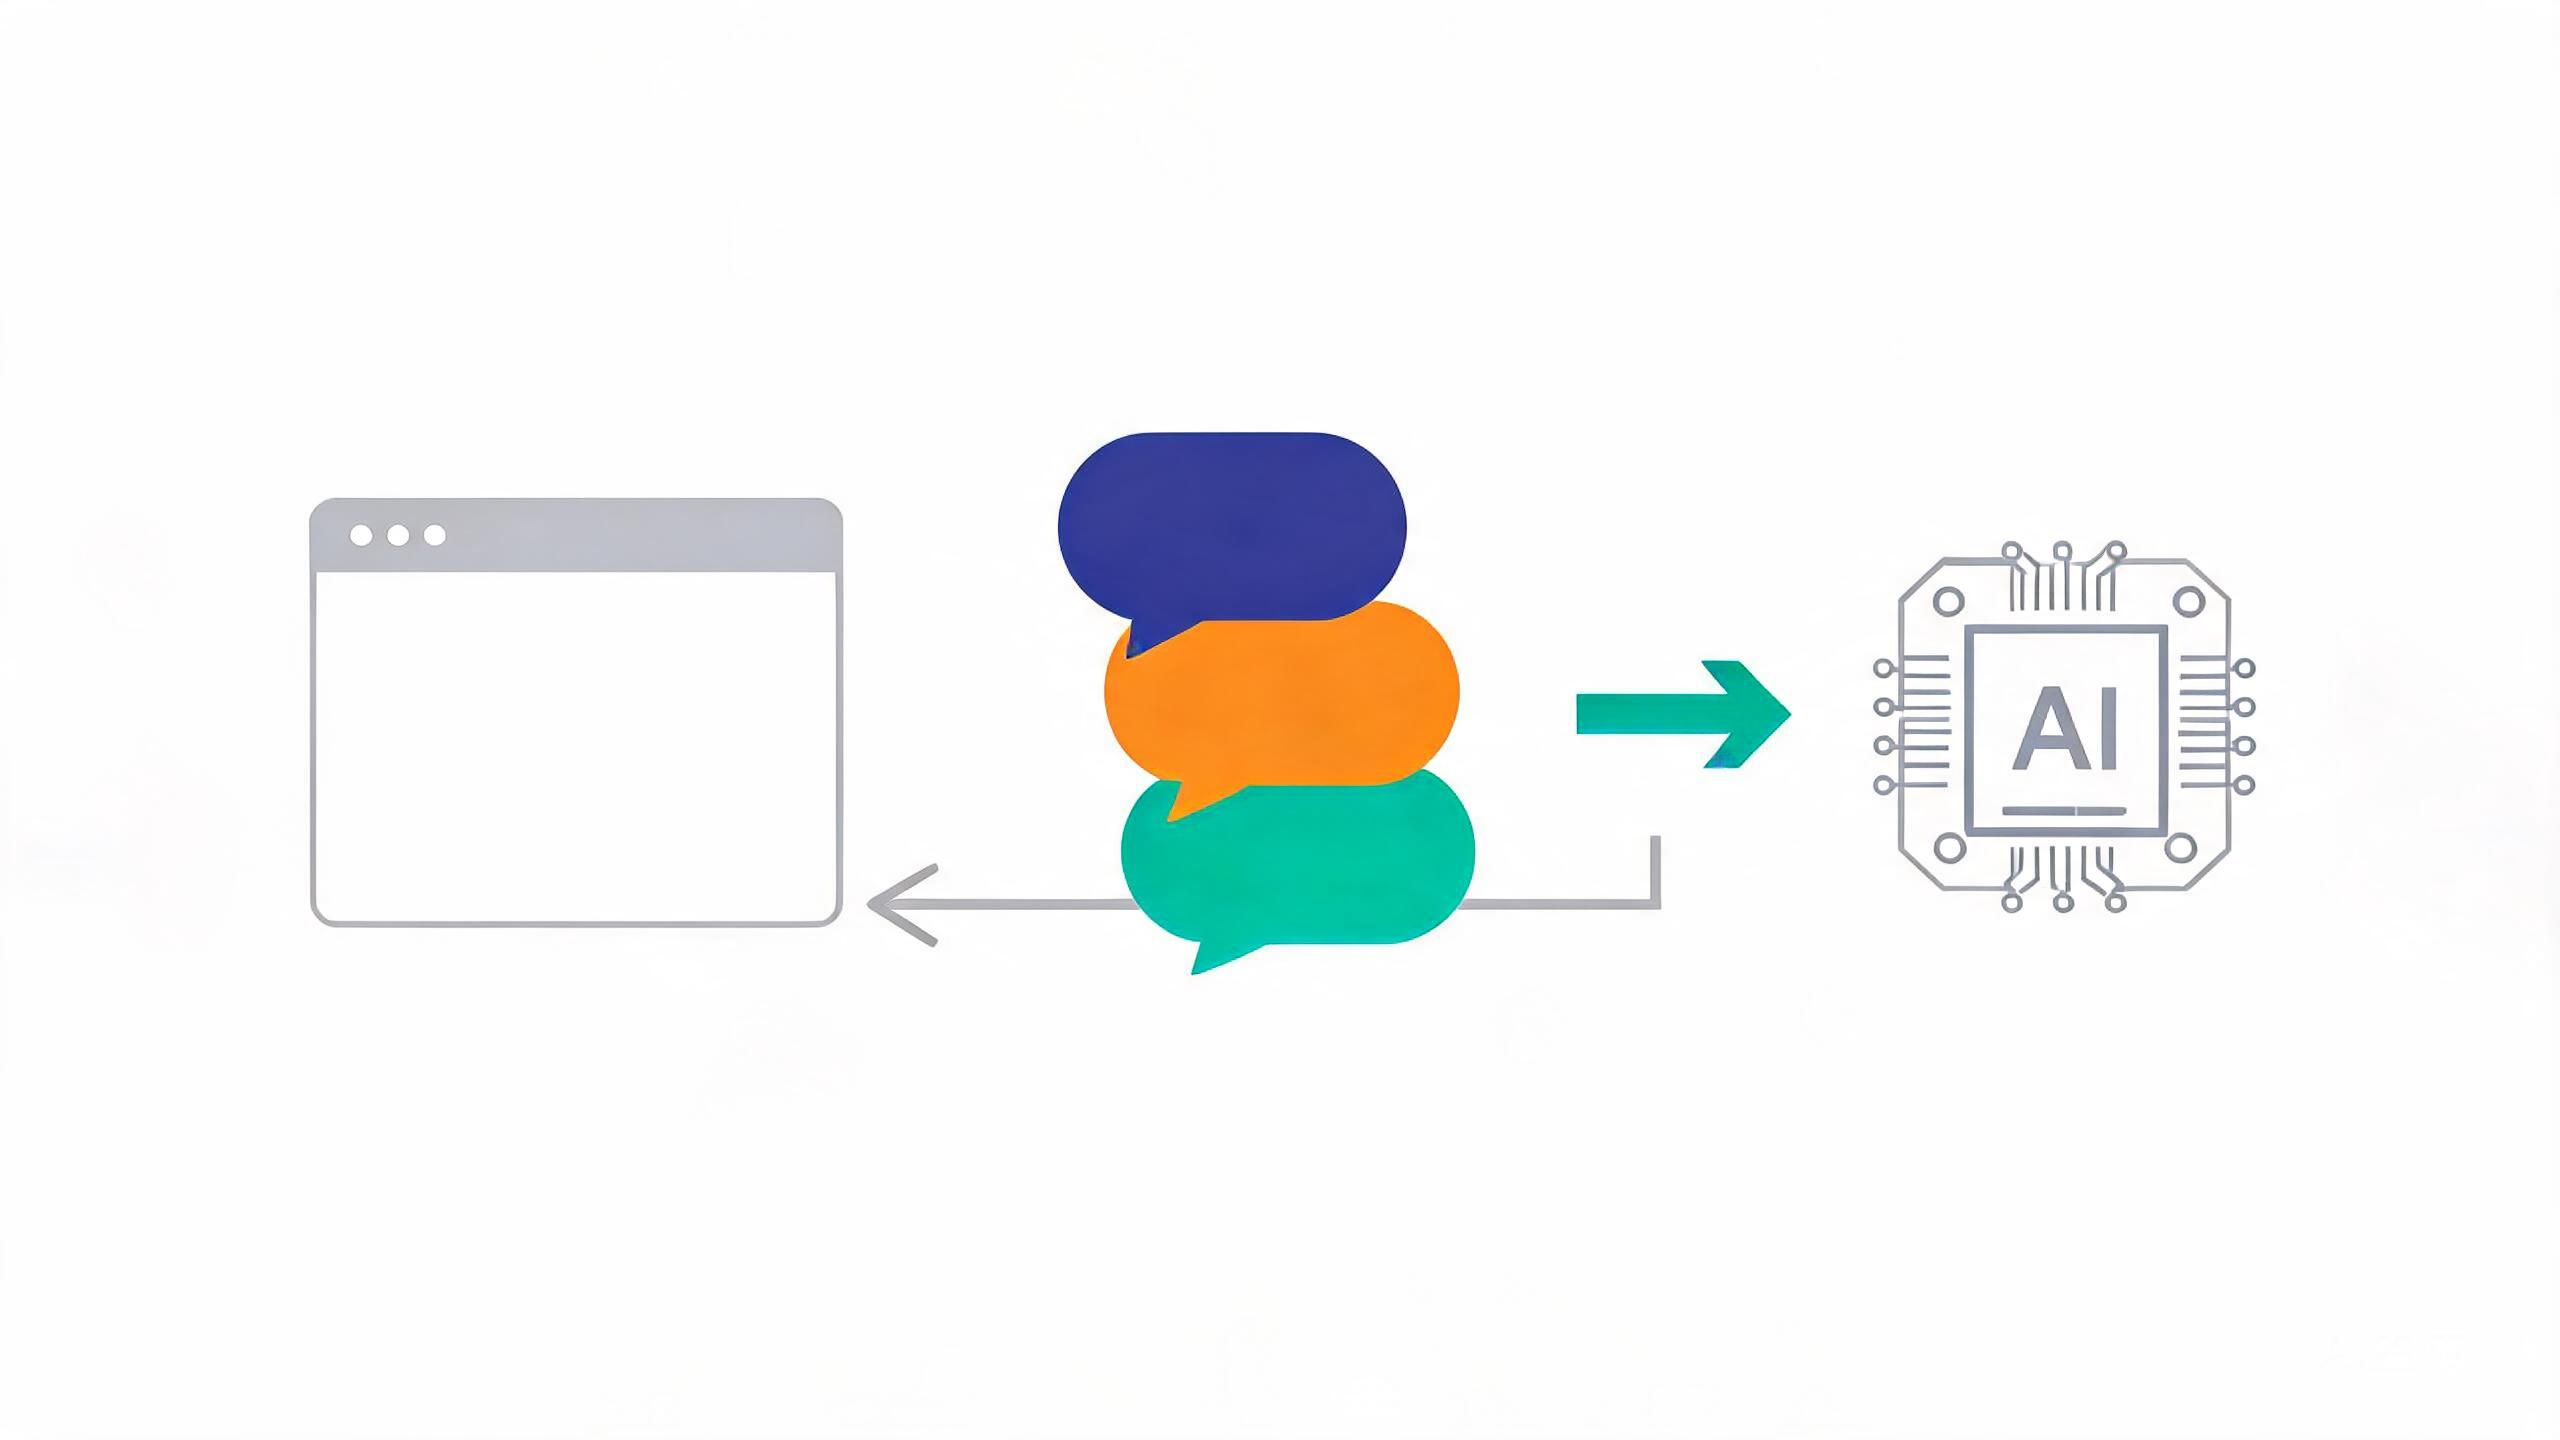
我以为 API 服务端会像微信聊天一样记住会话历史,结果发现 API 完全无状态——它根本不记得上一轮你们说了什么。所谓的”多轮对话”,是前端每次请求时,把历史消息重新完整地拼一遍塞进 messages 数组发过去。模型每次都是”拿着完整聊天记录重新读一遍再回答”。
4.1 多轮对话实现代码
理解了原理,实现就清晰了——前端维护一个 messages 数组,每轮把新消息 push 进去,再整体发送:
1 | class ChatSession { |
4.2 踩坑点:上下文长度是有限的
这里有个必踩的坑:gpt-3.5-turbo 的上下文上限是 4096 tokens(用户消息 + 历史消息 + 回答加起来)。聊得越久,拼出来的 messages 越大,一旦超过上限 API 直接报错。
我的处理策略是”滑动窗口”:超出预算时,从最老的轮次开始往后丢,但永远保留开头的 system 消息和最近几轮对话:
1 | function trimMessages(messages, maxTokens = 3000) { |
5. Token 与计费:说人话版本
第一次看账单我也有点懵,这里用大白话解释一下。
token 是什么? 可以把 token 理解成”文字的碎片单位”。英文大约 1 个 token ≈ 0.75 个单词(可以记 “tokens ≈ 4 字符”);中文更贵一些,大约 1 个汉字 ≈ 12 个 token。所以一段 500 字的中文提问,大约消耗 8001000 tokens。
钱怎么算? gpt-3.5-turbo 是 $0.002 / 1K tokens,输入输出都算钱。我这几天跑下来,日常开发调试一天大概烧几十美分,完全在”玩得起”的范围。但要注意几点:
- 多轮对话是”滚雪球”的:第 10 轮请求要把前 9 轮全部重发一遍,等于历史内容反复计费。聊 20 轮的实际消耗可能是单轮的十倍以上;
max_tokens能兜底回答长度,但兜不住历史消息的膨胀,所以第 4.2 节的裁剪逻辑很必要;- 上线前记得去 OpenAI 后台把消费上限设好,我给自己设了 $10,防止哪天循环写错了账户爆炸。
6. 血泪警告:API key 绝对不能放前端
这个必须单独一节,因为太重要了。我看到社区里已经有人直接把 key 写在网页 JS 里,然后调用接口,以为别人看不到——拜托,打开 DevTools 三秒钟就能把 key 抠出来,放到公网上不到十分钟就会被人爬走刷你的额度(OpenAI 官方甚至专门写了文章警告这个)。
正确做法:key 只存在自己的服务端,前端请求自己的后端,后端转发给 OpenAI。我写了个极简的 Express 代理:
1 | // server.js —— Node 代理,key 永远不出服务器 |
前端只请求 /api/chat,对 OpenAI 完全无感知。顺便建议在代理层再补两件事:登录态校验(防止接口被白嫖)和频率限制(比如每用户每分钟 10 次)。有了这层代理,后续想换模型、加缓存、做日志,都只是改后端的事。
7. 第一手感受
几天玩下来,说几个最直观的感受:
- 接口本身简单得惊人。概念上就一个 POST,难点全在”怎么用好它”——怎么写 system prompt、怎么管理上下文、怎么设计产品形态。这预示着一种新的技能方向,暂且叫它”模型工程”吧。
- 无状态设计既是坑也是自由。上下文完全由前端控制,意味着你可以随意裁剪、篡改、注入历史——想做”多角色对话”、”会话摘要压缩”这类玩法,主动权全在我们手里。
- 生态还非常早期。流式输出倒是发布当天就支持了(
stream: true,SSE 格式一段段吐 token,打字机效果就靠它),这点比预期厚道;官方 Node SDK 当天也更新了 chat 接口,但周边工具链基本空白,社区里已经冒出好几个非官方封装。回头看 2010 年的移动开发,也是这样的混沌期。 - 成本已经低到可以做出产品了。$0.002/1K 意味着一个日活千人的小应用,每天成本也就几美元,个人开发者完全玩得起。
列表之外补一句主观判断:这波 API 的”低门槛 + 高上限”组合非常少见——十分钟就能跑通第一行代码(低门槛),但要做出稳定、省钱、体验好的产品,却涉及提示词设计、上下文管理、工程化这一整套新知识(高上限)。回头看,这种组合往往意味着先入场的人能吃到一段不小的红利期,2010 年的移动开发如此,现在的大模型 API 大概率也是。
写在最后
作为第一次接入大模型的前端工程师,我的整体判断是:这不是一次普通的”新 API 发布”,而是一类全新能力变成了公共基础设施。就像当年 Ajax 打开了 Web 2.0 的门,/v1/chat/completions 这个接口可能会打开一个”所有产品都值得重新做一遍”的时代。
下一篇我打算研究怎么把大模型的输出更好地工程化——比如让它稳定输出 JSON、写单测、做代码 review,也就是大家开始讨论的”提示词工程”。如果你也在折腾,欢迎交流。