前言
我入行那会儿正好赶上 CSR(客户端渲染)的黄金年代,后来又亲历了 SSR 的回归、SSG 的流行,再到 React Server Components 的落地。每一次范式切换,本质上都是在回答同一个问题:”HTML 到底在什么时候、什么位置生成?”
今年做 AI 相关项目时我意识到,LLM 的 token 流正在成为第四种”渲染源”——页面不再只是从服务器或客户端拿现成的数据来渲染,而是随着模型的输出逐步”长”出来。这篇文章梳理这条渲染范式的演进线,再讲讲我在 Edge 上做 LLM 代理的实践:用 Vercel AI SDK 的 useChat 对比手写 SSE 到底简化了多少。
1. 渲染范式演进:一条线看懂
1.1 从 CSR 到 RSC,再到 AI 流式 UI
先用文字把这条线串起来:
1 | CSR → 浏览器下载空壳 JS → 拉数据 → 客户端渲染(白屏久,SEO 差) |
这条线的规律很清晰:渲染的位置在”客户端与服务器”之间来回摆,而渲染的时机在”请求 → 构建 → 持续”不断前移。AI 流式 UI 是最新的一个节点:渲染源从”数据库里的最终数据”变成了”模型正在生成的过程数据”。
如果对 RSC 还不熟悉,一句话科普:它允许组件”只在服务器上渲染”,输出以序列化结构下发,组件对应的 JS 根本不会进浏览器 bundle——数据获取和渲染合二为一,也就不需要为水合再发一遍数据。理解这点很重要,因为后文”让组件随模型输出渐进生成”,正是建立在 RSC 的服务端渲染能力之上。
2. Next.js App Router 的 Streaming SSR 与 Suspense
App Router 把流式渲染做成了默认能力:Server Component 里 await 一个慢请求,用 <Suspense> 圈住它,框架就会先把页面的壳流出去,慢的部分就绪后再补发。
1 | // app/article/[id]/page.tsx |
这套机制正好是 AI 流式 UI 的底座:流式 SSR 让内容分块到达、分块渲染,而 LLM 天然就在生产”分块”的内容——token 流。
3. AI 时代”渲染”的新含义:token 流即渲染源
传统渲染里,数据是”完成时”的:接口返回时数据已经完整。而 LLM 的输出是”进行时”的:用户按下发送键的那一刻,内容还不存在,它以每秒几十个 token 的速度被”生产”出来。
这带来一个思维转变:与其等模型全部生成完再一次性渲染(那用户体验还不如纯 CSR),不如把 token 流直接接进渲染管线:markdown 边到边渲染、代码块逐字打出、结构化数据边解析边填表格。**”渲染”从”把数据变成像素”扩展成了”把正在生成的数据变成像素”**。
举个具体的体感差异:让模型”写一篇 2000 字的游记”,如果等全部生成完再展示,用户要盯着转圈等 20 秒;而流式渲染下,标题 1 秒内出现、第一段 3 秒内出现,用户从”等待者”变成了”旁观创作的人”。同样的总耗时,前者是慢,后者是沉浸。所以 AI 产品的体验差距里,渲染管线这一半经常被低估。
4. Edge Runtime 上的 LLM 代理
4.1 手写 SSE 有多痛苦
之前 DeepSeek 接入那篇文章里,我手写过一遍 SSE 解析:监听 fetch 的 ReadableStream、按空行切消息、剥 data: 前缀、处理 [DONE]、处理 JSON parse 容错……前后端加起来上百行样板代码,还有边界情况要小心,比如网络分块恰好切断一条 SSE 消息时,得自己维护缓冲区。
4.2 Vercel AI SDK:route.ts + useChat
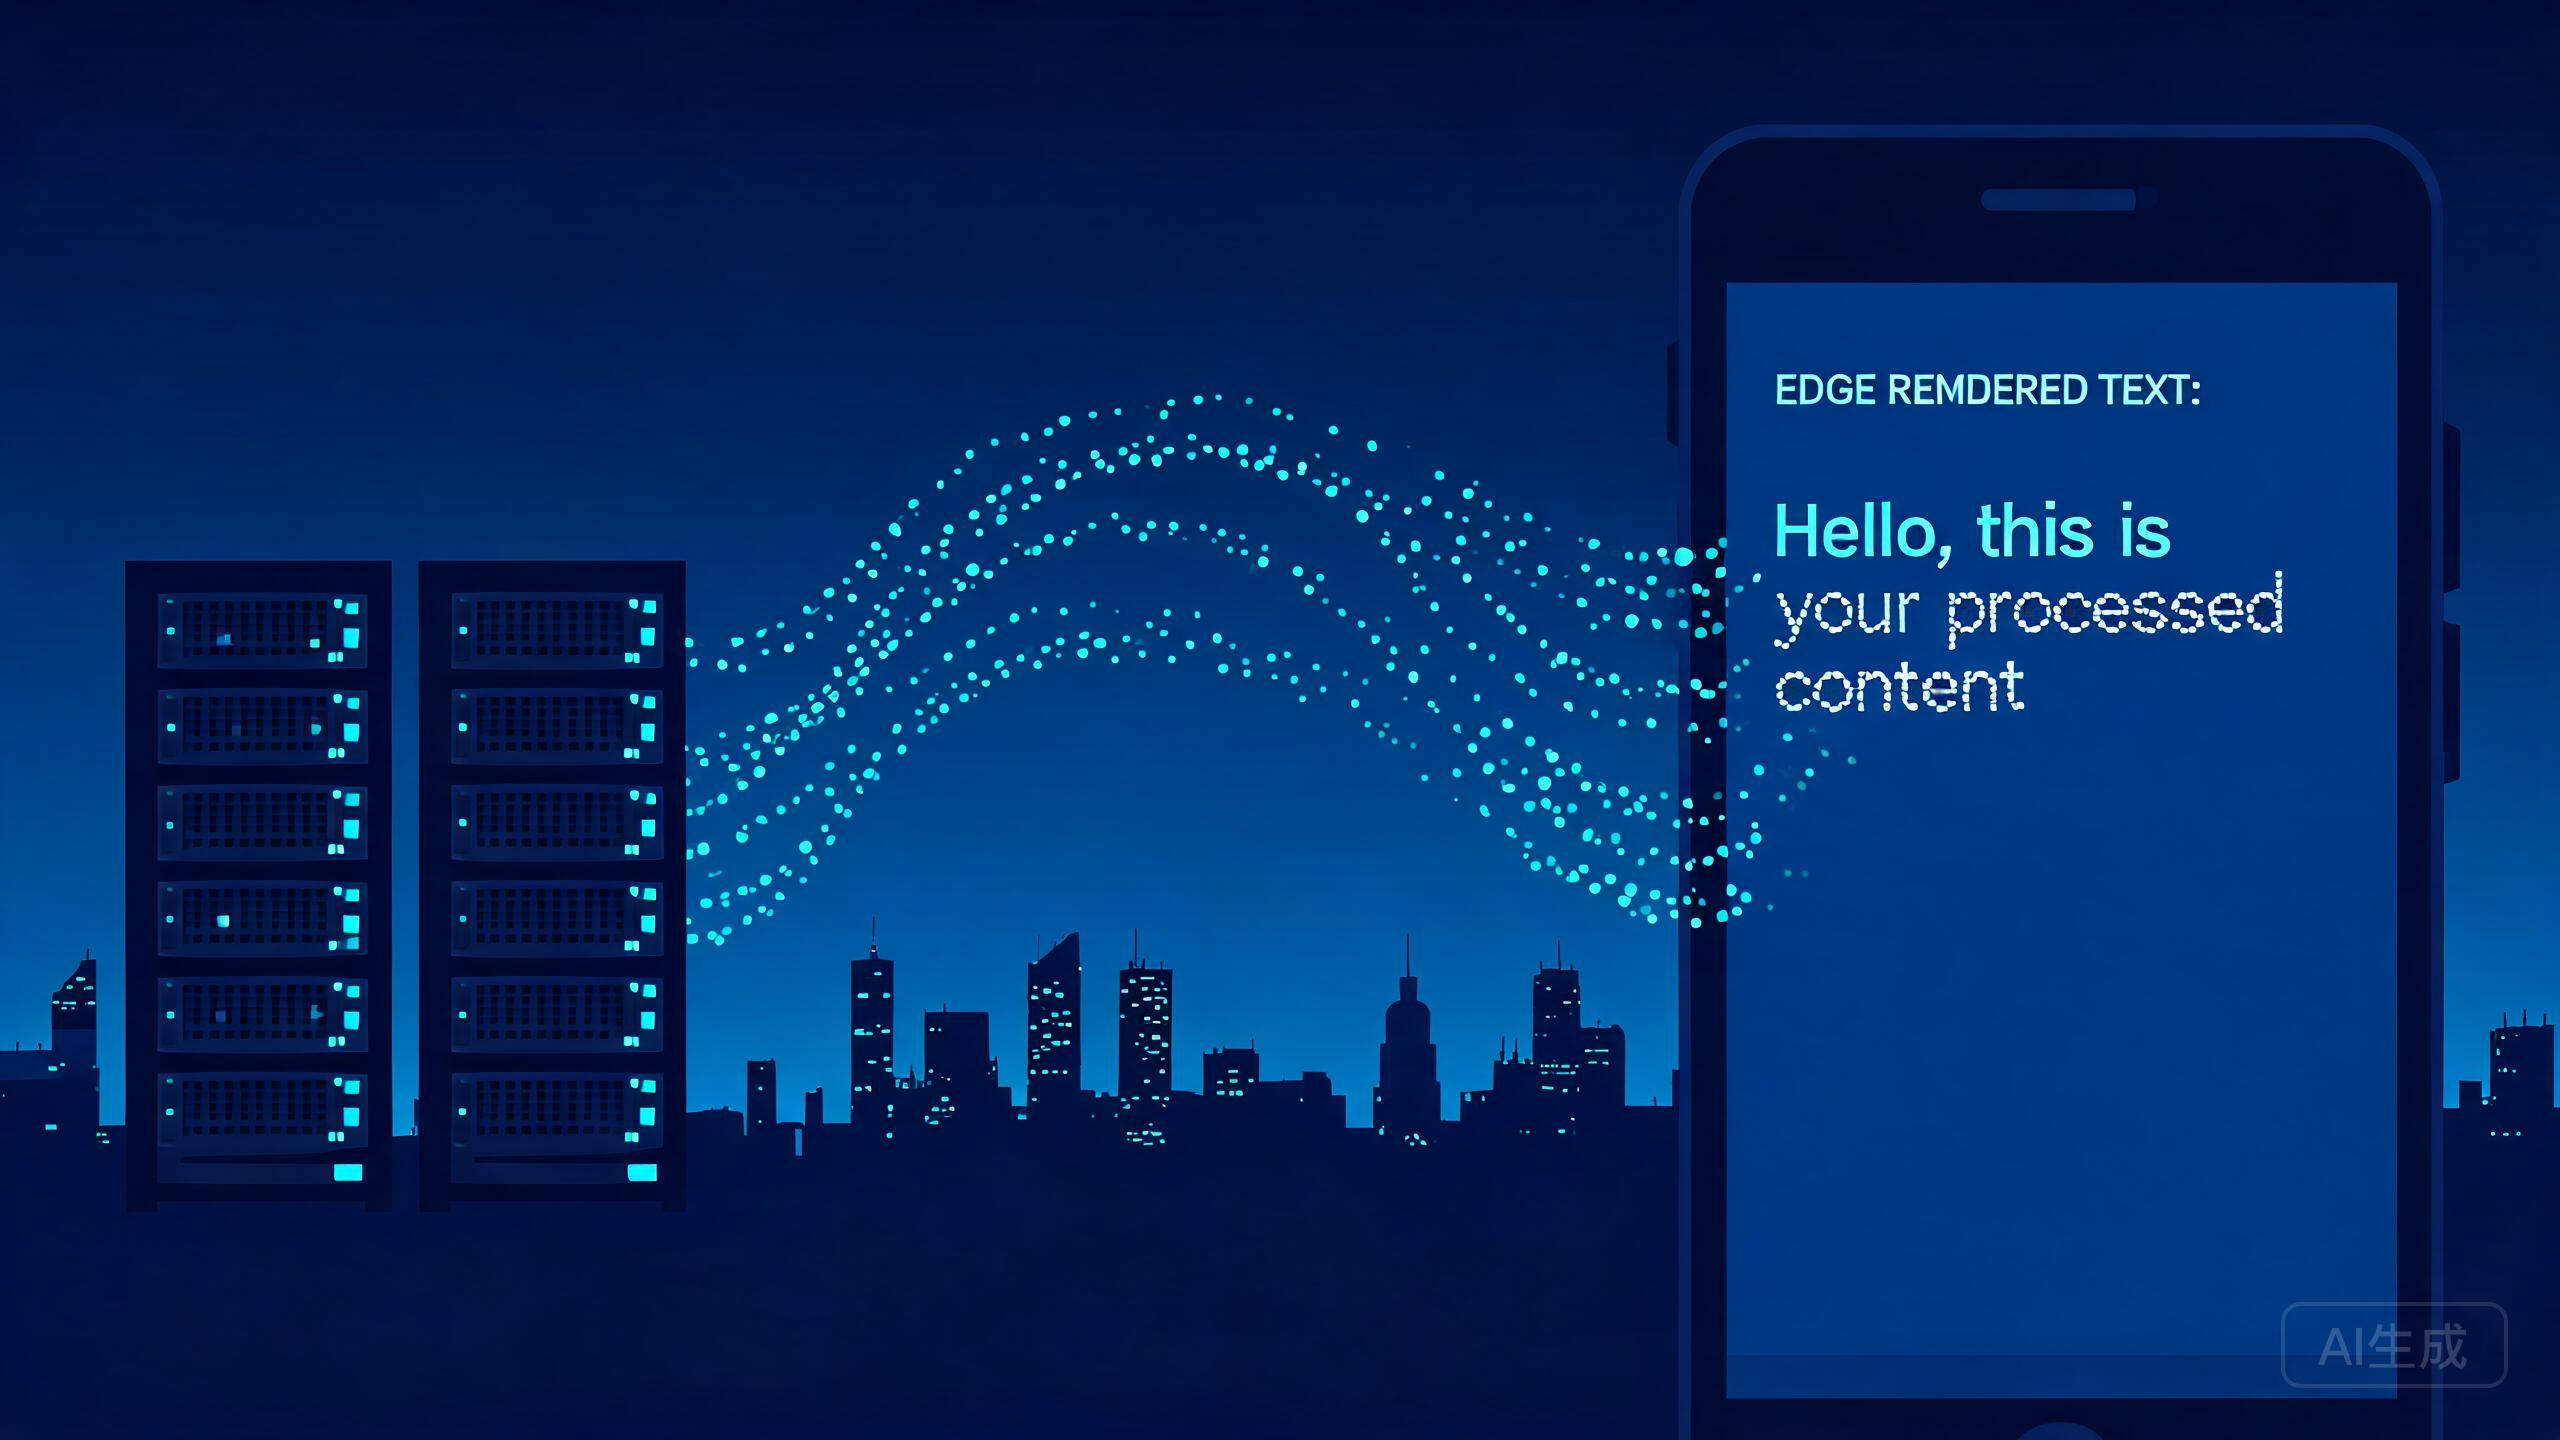
在 Edge Runtime(比如 Next.js 的 route handler)上部署 LLM 代理,AI SDK 把流式协议的脏活全包了。
后端 app/api/chat/route.ts,核心逻辑五行:
1 | import { streamText } from "ai"; |
前端一个 useChat 搞定全部状态:
1 | "use client"; |
对比手写 SSE:后端从”拼 ReadableStream + SSE 格式”变成一行 toDataStreamResponse();前端从”自己维护增量文本 + 手动 setState”变成一个 hook,连 streaming 状态机、中断停止都替你做好了。唯一要适应的是它的数据流协议不是裸 SSE,内部带了工具调用等元信息,如果要对接自家已有的 SSE 网关,需要做一层适配。
再补一个 Edge 的实战观察:Edge Runtime 没有 Node 的完整运行时(没有 fs),但 fetch 是一等公民、冷启动在毫秒级。LLM 代理这种”纯转发 + 流式”的负载,天然适合 Edge:无状态、不占长连接池、离用户近。
5. RSC 里随模型输出渐进生成
比”对话流式”更进一步的是把 RSC 和流式结合:模型生成的结构化数据,直接驱动组件渐进渲染。
一个典型场景是”AI 生成行程页”:模型按 schema 流式吐出 JSON,前端不渲染 markdown,而是把每个”景点”作为一个卡片分片,来一个渲染一个:
1 | "use client"; |
AI SDK 的 streamObject(流式返回”部分合法”的对象)就是为这个场景准备的:拿到什么渲染什么。这种”组件随模型输出渐进生成”的体验,纯客户端方案很难做到——类型约束在服务端、渲染也在服务端,客户端只消费流。
增量解析是这个方案里最容易低估的难点:模型吐出的 JSON 在任意时刻都可能停在”半个字段”的状态,直接 JSON.parse 必炸。AI SDK 的流式对象接口在内部做了前缀容错;如果自己实现,思路是按结构逐层校验、只取”已经闭合”的部分。另外记得给每个分片一个稳定的 key,不然流式渲染时 React 会把已渲染的卡片整批重挂,视觉上会闪一下。
6. 性能指标新解:TTFT 比 FCP 更重要
传统前端性能的三板斧是 FCP、LCP、TTI。但在 AI 产品里,用户感知最强烈的指标是 TTFT(Time To First Token,首 token 时间):按下发送键到第一个字出现在屏幕上的时间。
原因很直觉:聊天场景下用户对”开始响应”极其敏感——TTFT 500ms 和 3s 是两个产品;而”全部生成完”的耗时反而不那么关键,因为内容是流式出现的,用户早就开始读了。
我在实践中压 TTFT 的几个手段:模型侧选首 token 响应快的模型;网络侧把代理放到 Edge,减少一跳;工程侧复用连接、避免在首 token 前做任何重计算;再配合 Suspense 骨架,让”等待”被结构化的 UI 填满,而不是白屏转菊花。
怎么度量?我在代理层埋了点:记录请求发出时间与上游返回第一个 delta 的时间差,按 P50/P90 聚合。有个反直觉的发现:TTFT 的 P90 往往被冷启动和上游限流拖垮,所以监控一定要看分位数而不是平均值,否则会被”大多数请求很快”的假象安慰。
7. 架构思考
把这半年的实践沉淀成三句话:
- 流式是 AI UI 的默认形态,不是优化项。架构设计时要把”内容不完整”当作常态,状态机和骨架都按这个前提来设计;
- Edge 是 AI 代理的默认部署位置。无状态、流式友好、冷启动快,和 LLM 负载天生契合;
- 协议层值得抽象。token 流、工具调用、结构化输出会长期共存,用 AI SDK 这类中间层隔离协议细节,才能随时换模型而不伤 UI。
写在最后
写完这篇最大的体会:流式 UI 的复杂度不在渲染本身,而在状态机和错误处理,比传统 SSR 琐碎不少,排期时得单独留出这块。下一篇文章我来盘点这一年重度使用的 AI 编程工具,聊聊工作流的重构。