前言
去年写 Function Calling 和 Agent UI 那几篇文章的时候,我反复遇到同一个困扰:让大模型”接上”真实世界的数据,每个应用、每个数据源都得单独写一遍胶水代码。给 Claude 接 GitHub 是一套封装,给 Cursor 接同样的 GitHub 又是另一套,自己写的客服机器人想查数据库还得再来一遍。这些适配逻辑高度雷同,却完全无法复用。
今年年初我认真研究了 Anthropic 开源的 Model Context Protocol(下文简称 MCP),越看越觉得它像是 AI 应用生态里的”USB-C 接口”。这篇文章从前端视角聊聊:MCP 到底解决什么问题、架构长什么样,以及如何动手写一个最小可用的 MCP Server,最后附上我踩过的坑。
1. MCP 是什么:从 M×N 到 M+N
1.1 M×N 集成难题
在 MCP 出现之前,AI 应用接入外部能力是一个典型的 M×N 问题:M 个 AI 应用(Claude Desktop、Cursor、各种自研 Agent)要对接 N 个数据源(GitHub、Slack、Postgres、本地文件……),理论上最多要写 M×N 份适配代码。更糟的是这些代码彼此不通用:每家的调用约定、鉴权方式、数据格式都不一样。
用文字画个示意图对比一下:
1 | 接入前(M×N):每个应用 × 每个数据源,都要单独写适配 |
MCP 的思路很简单:把”应用侧”和”数据源侧”解耦。数据源方只要实现一次 MCP Server,所有支持 MCP 的应用都能直接用;应用方只要实现一次 MCP Client,就能接入整个生态。M×N 的集成难题就退化成了 M+N。
1.2 一层薄薄的协议
MCP 本质上是一份基于 JSON-RPC 2.0 的协议规范,官方提供了 TypeScript 和 Python 的 SDK,传输层支持 stdio(本地子进程)和 HTTP + SSE(远程服务)。对前端来说,它的心智模型接近”给 AI 用的 RPC”:客户端发 tools/list 问你有什么能力,发 tools/call 调用某个工具,你按协议回 JSON 就行。
一次完整的会话大致是这样的:Host 启动时通过 initialize 握手交换协议版本和能力声明;接着 Client 发 tools/list 拉取工具清单(名称、描述、入参 schema),把这份清单注入模型的系统提示;模型决定调用某个工具后,Host 再发 tools/call,由 Server 执行并把结果作为一条工具消息回给模型。整个过程对模型完全透明——模型看到的只是”有哪些工具可用”,它并不知道背后是 MCP。
2. 架构一览:Host、Client 与 Server
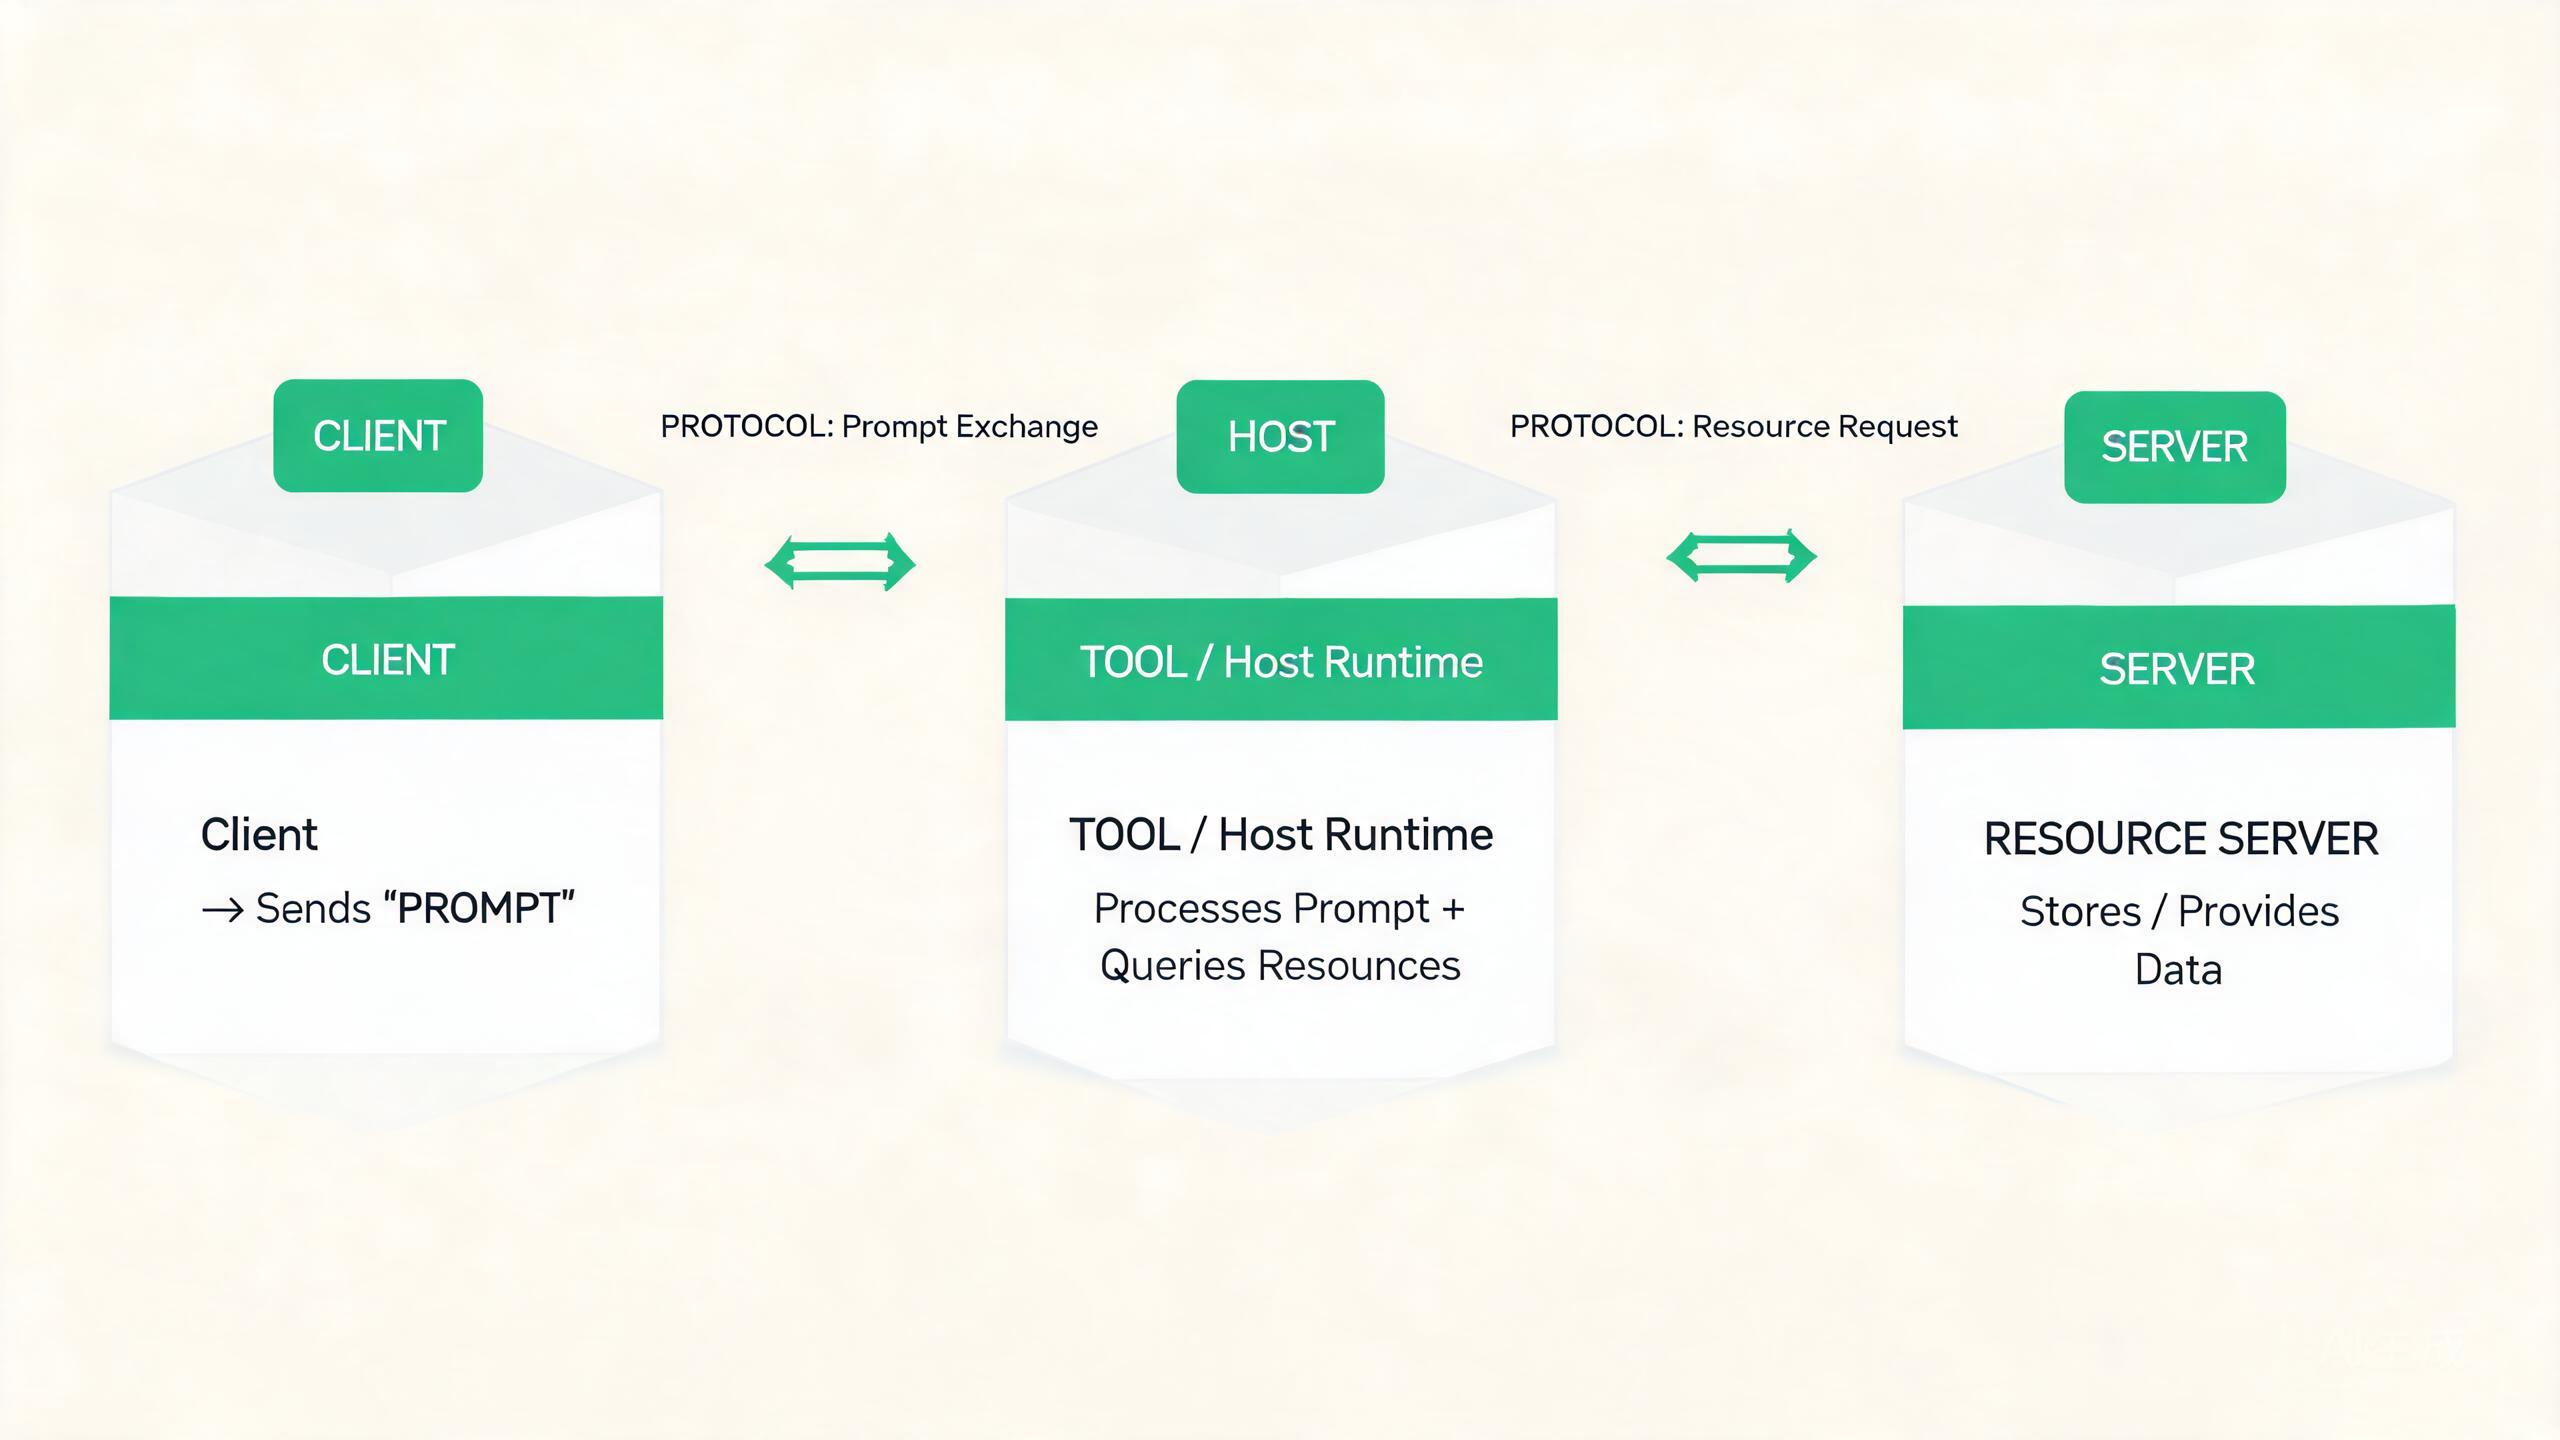
MCP 的角色划分有点绕,第一次看很容易混淆,我用自己的话解释一遍:
- Host:承载 AI 对话的宿主应用,比如 Claude Desktop、Cursor,或者你自己的聊天界面。它是”用户”。
- Client:跑在 Host 内部的连接器,每个 Client 与一个 Server 保持 1:1 的会话,负责协议握手与消息路由。
- Server:对外暴露能力的轻量服务,可以是一个本地子进程,也可以是一个远程 HTTP 服务。
Server 对外提供三类原语,MCP 的核心基本就是这三样:
- Resources:只读数据,比如文件内容、数据库记录,类似 GET 接口,模型可以”读取”;
- Tools:可执行的动作,有副作用,类似 POST 接口,也就是 Function Calling 的 MCP 版;
- Prompts:预置的提示词模板,让 Server 作者把最佳实践打包分发给用户。
3. 动手写一个最小 MCP Server
3.1 初始化项目
用官方 TypeScript SDK,五分钟就能跑起来:
1 | # 直接在博客仓库根目录下操作,把 Server 当作仓库里的一个脚本 |
3.2 实现”查询博客文章列表”工具
我的博客是 Hexo 驱动的,文章就是 source/_posts 下的一堆 Markdown。下面这个 Server 暴露两个工具:列出文章列表、按关键词搜索文章正文。
1 |
|
几个容易忽略的点:
server.tool()的第三个参数用 zod 定义入参 schema,SDK 会自动生成符合协议的inputSchema,模型就是靠它知道该怎么传参;- 工具返回值统一包在
content数组里,文本用type: "text";如果要返回截图之类的图片,可以用type: "image"传 base64; - 把上面的代码存成博客仓库里的
scripts/mcp-server.ts,运行方式是在博客根目录执行npx tsx scripts/mcp-server.ts,这样process.cwd()才指向博客目录,工具才能找到source/_posts。
3.3 在 Claude Desktop 里调试
打开 Claude Desktop 的配置文件(macOS 在 ~/Library/Application Support/Claude/claude_desktop_config.json,Windows 在 %APPDATA%\Claude\claude_desktop_config.json):
1 | { |
重启 Claude Desktop,输入框右下角出现工具图标就说明握手成功了。这时问它”我博客里写过哪些跟 AI 相关的文章?”,它会自动调用 list_posts,再视情况用 search_posts 检索关键词,全程不需要写任何一行 Claude 特定的代码,这就是统一协议的价值。
4. 前端视角:MCP 与 Function Calling 的关系
很多人第一反应是:这不就是 Function Calling 换了个皮?我的理解是两者工作在不同层次:
- Function Calling 是模型层能力,各家私有:OpenAI、Anthropic、DeepSeek 各有一套 schema 格式,之前 DeepSeek 接入那篇文章里我就专门封装过这层。它解决的是”模型如何决定调用哪个函数”。
- MCP 是应用层开放协议:它不关心底下模型用什么方式做函数调用,只规定”能力如何被描述、被发现、被调用”。同一个 MCP Server 今天接 Claude,明天接 Cursor,后天接自己写的 Agent,都不用改。
可以这么类比:Function Calling 是各家 CPU 的指令集,MCP 是 USB 标准。未来大概率是模型继续各自演进指令集,而外设生态统一到 MCP 这类协议上。
实际落地时两者是配合关系:Host 先从 MCP Server 拿到工具清单,转换成当前模型厂商的 function calling 格式喂给模型;模型吐出调用意图后,Host 再翻译回 MCP 的 tools/call 发给 Server。换句话说,MCP 负责”能力的定义与发现”,Function Calling 负责”模型的决策与触发”,谁也替代不了谁。
5. 踩坑记录
5.1 stdio 传输下千万别往 stdout 打日志
这是新手必踩的坑。stdio 模式下 stdout 是协议消息专用通道,任何 console.log 都会输出到 stdout,直接把 JSON-RPC 消息流污染,客户端立刻报”invalid JSON”。调试信息请一律走 console.error(stderr)。
5.2 Windows 路径与命令解析
在 Windows 上配置 Claude Desktop 时有两个坑:一是 JSON 里的路径反斜杠要转义,写 E:\\code\\... 而不是 E:\code\...;二是 command 写 npx 在某些机器上解析不到,需要写成 npx.cmd,或者干脆用 node 直接跑编译后的 JS。另外 SDK 的子路径导入(@modelcontextprotocol/sdk/server/mcp.js)要求 package.json 里声明 "type": "module",否则运行时会报模块加载错误。
5.3 权限与安全
MCP Server 跑在你本机,拥有和你的用户进程同等的文件系统权限。Claude Desktop 每次调用工具前会弹出授权确认,但自己写的 Host 就要自己做这一层了。我的建议:只读工具要在描述里说清楚无副作用;任何带写操作的工具都要二次确认;不要把 API Key 之类敏感信息通过工具返回给模型。
6. 生态展望
写这篇文章的时候,MCP 的生态还在爆发前夜:官方开源了一批 Reference Server(GitHub、Slack、Postgres 等),社区里文件系统、浏览器自动化、数据库方向的 Server 已经很活跃。对前端工程师来说,这里有明显的角色空缺:写 MCP Server 的体验很像写 BFF/中间层,定义 schema、处理路由、返回结构化数据,全是前端的舒适区。我甚至觉得每个团队都值得写几个内部 MCP Server:把内部文档库、工单系统、发布平台包一层,团队成员的 Claude 和 Cursor 就直接”认识”了这些系统。相比每人写一遍浏览器插件或者临时脚本,这是一次投入、全员受益的公共基建,太适合前端来牵头了。
写在最后
从去年写 Function Calling 到今天写 MCP,我的体感是:AI 应用的”集成层”正在快速标准化,就像十年前大家从各自为政的 HTTP 调用走向 Swagger/OpenAPI 一样。前端正好卡在”协议、界面、工具”三件事的交汇处,这活儿躲不开,早点趟一遍不亏。下一篇我打算聊聊多模态,把 Vision API 和 Web Audio 玩起来。